アバター生成
キャラクター・アバター
オープンソース
-
AptAvatar AIが発見
2026
プロダクション対応の高速かつ表現力豊かな推論向けに設計された、140億パラメータの長尺オーディオ駆動型アバター生成フレームワーク。終点アンカー型分布蒸留と自己生成履歴リプレイを利用し、長時間の生成でも品質を損なうことなく、生き生きとした動きと高精度な動画生成を実現します。
audio-drivendistillationtalking-headvideo-generation -
Avatar Forcing AIが発見
2026
ディフュージョン・フォーシング(Diffusion Forcing)を介してユーザーとアバターのインタラクションをモデル化し、リアルタイムのマルチモーダル入力を処理して表情をミラーリングできる、リアルタイム・インタラクティブ・ヘッドアバター生成フレームワーク。
avatarinteractivereal-timetalking-head -
Avatar-Forever AIが発見
2026
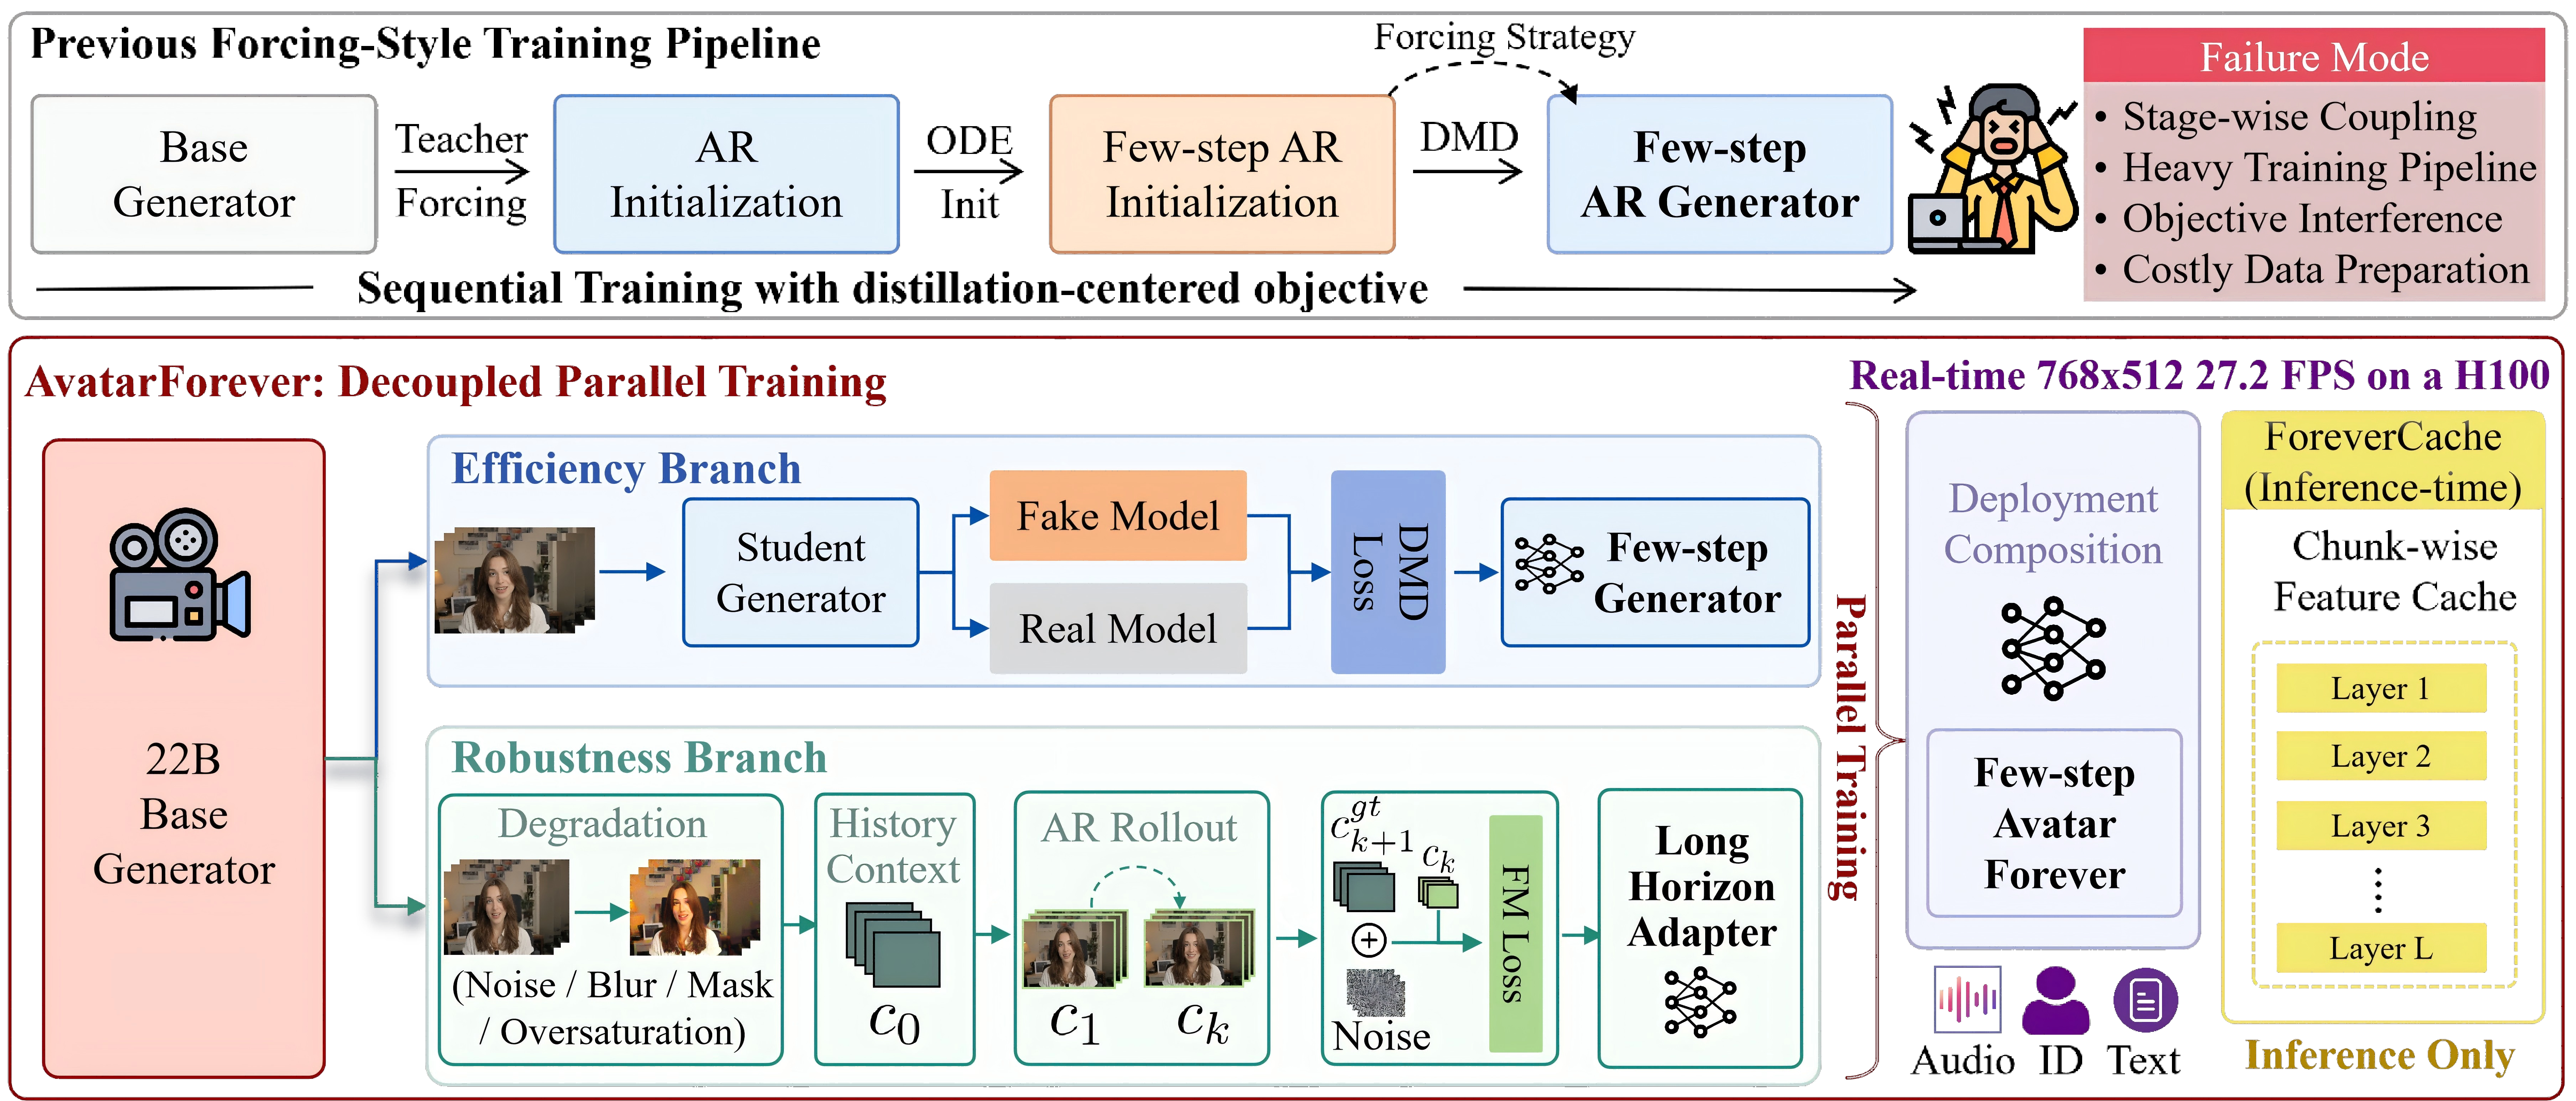
高品質、リアルタイム、かつ実質的に無制限の音声駆動型アバター生成のための、分離型並列学習フレームワーク。生成効率と長期的なロバスト性を並列に学習可能な独立した機能として扱い、単一のH100上でLTX-Videoバックボーンを用いて27.2 FPSを達成します。
audio-drivenavatarreal-timetalking-head -
DAMA AIが発見
2026
絡み合いを解いた身体固定のガウシアン(Disentangled Body-Anchored Gaussians)を用いて、明確な境界とレイヤー順序の制御が可能な、複数レイヤーの衣服を着た3Dアバターを再構成する手法。
avatarclothed-humangaussian-splatting -
DynaAvatar AIが発見
2026
単一の画像から、動きに連動する衣服のダイナミクスを備えたアニメーション可能な3Dアバターを再構成するゼロショットフレームワーク。Transformerベースのフィードフォワードアーキテクチャを採用し、被写体固有の最適化なしで動的な3D Gaussianの変形を予測します。
3dgsavatarcloth-dynamicszero-shot -
GenLCA: 3D Diffusion for Full-Body Avatars from In-the-Wild Videos AIが発見
2026
Metaと浙江大学が開発した拡散ベースの生成モデル。テキストや画像入力からフォトリアルでアニメーション可能な全身の3D Gaussianアバターを生成・編集し、大規模な野生のビデオデータでトレーニングされています。
3dgsavatardiffusionvideo-to-3d -
Hallo-Live AIが発見
2026
非同期デュアルストリーム拡散と人間中心の好みに基づく蒸留を組み合わせた、リアルタイムストリーミング対応の音声・映像統合アバター生成フレームワーク。
avatarreal-timetalking-head -
HumanNOVA AIが発見
2026
単一のRGB画像からアニメーション可能な高精度3Dアバターを高速に生成するフレームワーク。リギング済みアセットと多様なポーズを活用したスケーラブルなデータ生成パイプラインにより、高い汎用性と写実性を実現しています。
3d-humanavatargaussian-splatting -
LongCat-Video-Avatar AIが発見
2026
安定したリップシンクと一貫したアイデンティティを維持しながら、長時間の動画生成をサポートする、オープンソースでプロダクション対応の音声駆動型トーキングアバター動画生成フレームワーク。
avatardiffusiontalking-head -
LUNA AIが発見
2026
画像、キーポイント、スケッチなどの多様な2D制御を3Dガウシアンの変形に直接マッピングする、LBS(Linear Blend Skinning)フリーの汎用ニューラルアニメーションモデル。明示的なボディフィッティングやスキンニングを回避し、リアルな人間動作とゼロショットのクロスアイデンティティ一般化を実現します。
3d-gaussiananimationavatarlbs-free -
Monocular Avatar Reconstruction via Cascaded Diffusion Priors and UV-Space Differentiable Shading AIが発見
2026
段階的な拡散モデルの事前知識とUV空間の微分可能シェーディングを活用し、1枚の野生画像から高精度で再ライティング可能な3Dアバターを再構成するフレームワーク。
3d-avatarmonocular-reconstructionrelightable -
MVCHead AIが発見
2026
ランダムにサンプリングされた2D画像のみから、マルチビュー一貫性のある3Dガウシアンヘッドアバターを学習するシングルショット状態空間モデル。マルチビューデータセットや3Dの教師データ、中間ビュー生成を必要としません。
avatargaussian-splattinghead-avatar -
SplatShot AIが発見
2026
単一の制約のない写真から写実的な3D顔アバターを再構成するフレームワーク。フィードフォワード型の3D Gaussian Splattingと2D拡散モデルの事前分布を組み合わせることで、幾何学的一貫性と写実性を両立しています。
avatarface-avatargaussian-splatting -
UP2You: Fast Reconstruction of Yourself from Unconstrained Photo Collections AIが発見
2026
極めて制約の少ない野生の2D写真から、直交マルチビュー画像と法線マップに補正することで、高精度な3D衣服付きポートレートを再構成するチューニングフリーのソリューション。
avatarmeshmulti-viewreconstruction -
AdaHuman AIが発見
2025
ポーズ条件付きの3D関節拡散モデルと3D Gaussian Splatting再構成を用いて、単一の野生画像から高精度でアニメーション可能な3Dアバターを生成するフレームワーク。
3d-humanavatargaussian-splatting -
AnimPortrait3D AIが発見
2025
3D Gaussian表現をモーファブルヘッドモデルと位置合わせすることで、正確な表情アニメーション制御を可能にする、テキスト駆動型のリアルなアニメーション対応3DGSヘッドアバター生成フレームワーク。
3dgsavatarheadtext-to-3d -
Avat3r AIが発見
2025
わずか数枚の入力画像から高品質でアニメーション可能な3Dヘッドアバターを回帰的に生成する、大規模アニメーション可能ガウシアン再構成モデル。テスト時の最適化や計算コストを大幅に削減します。
avatargaussian-splattinghead-avatar -
GSAC: Leveraging Gaussian Splatting for Photorealistic Avatar Creation with Unity Integration AIが発見
2025
スマートフォンのビデオからフォトリアルでアニメーション可能なアバターを作成する3D Gaussian Splattingフレームワーク。Unityゲームエンジンへのシームレスな統合をサポートし、リアルタイムのインタラクティブなアプリケーションに対応します。
3d-avatargaussian-splattingreal-timeunity -
InfiniHuman AIが発見
2025
2D拡散モデルと堅牢な3D再構成パイプラインを用いて構築された大規模な3D人間データセットを活用し、テキスト、衣服、ポーズ、体型などの多様な入力から、精密に制御された3Dアバターを生成するフレームワーク。
3d-avataravatar-generationcontrollable-generationsiggraph-asia -
JoyStreamer-Flash AIが発見
2025
高度な拡散トランスフォーマーを介してリアルタイムで無限長の会話アバタービデオを合成する音声駆動型自己回帰生成モデル。優れたリップシンク、時間的一貫性、および視覚的忠実度を保証します。
autoregressiveavatarreal-timetalking-head -
LHM: Large Animatable Human Reconstruction Model from a Single Image in Seconds AIが発見
2025
LHMは、1枚の入力画像から数秒でアニメーション可能な3Dヒューマンアバターを生成するフィードフォワード型の大規模アバター再構成モデルです。幾何形状・外観・変形を分離学習することで、長時間の最適化なしで動的な3Dキャラクターを生成します。
3d-avataranimatable-humangaussian-splattingsingle-image-to-3d -
LiveAvatar AIが発見
2025
140億パラメータの拡散モデルをベースにした、リアルタイム、ストリーミング、無限長の音声駆動型アバター動画生成のためのアルゴリズム・システム共同設計フレームワーク。
audio-drivenavatarreal-timestreaming -
OmniHuman-1.5 AIが発見
2025
ByteDanceが開発した、認知シミュレーションを統合して意味的に一貫した表現力豊かなキャラクターアニメーションを生成する高度なビデオアバター生成フレームワーク。マルチモーダル大規模言語モデルを活用して高レベルの意味的ガイダンスを提供し、音声のリズムや感情の文脈に合わせたリアルな全身の動きと表情を生成します。
avatarbytedancediffusion-transformertalking-head -
2025
単眼ビデオから衣服を着用したアバターを再構成するために、明示的なメッシュ幾何学上に3Dガウシアン(Gaussian Splatting)を埋め込む新しいヒューマンアバター表現。ポーズに関連するガウシアン補正モジュールを備え、複雑な変形を捉えることで、リアルさと表現力を向上させます。
3d-gaussianavatarmonocular-videoreconstruction -
2025
さまざまな顔や体のモーション信号によって駆動され、モバイルやARデバイス上でリアルタイムに動作するように設計された、高精度かつ軽量な3DGSベースの全身トーキングアバターフレームワーク。
3dgsaugmented-realityavatarreal-time -
TeRA: Rethinking Text-guided Realistic 3D Avatar Generation AIが発見
2025
潜在拡散モデル(Latent Diffusion Model)に基づく、テキスト指示型のリアルな3Dアバタ生成フレームワーク。2段階の学習戦略を採用し、大規模な人物再構成モデルから構造化された潜在空間をデコーダに蒸留することで、高速なフィードフォワード生成とテキストによる部分的なカスタマイズを可能にします。
avatardiffusionreconstructiontext-to-3d -
AniGS: Animatable Gaussian Avatar from a Single Image with Inconsistent Gaussian Reconstruction AIが発見
2024
単一の画像からアニメーション可能な3D人物アバターを生成する手法。ビデオ拡散モデルを利用してマルチビューの標準ポーズ画像を生成し、マルチビュー間の不整合を4D Gaussian Splattingの時間的変化としてモデリングすることで、高精度な再構成とリアルタイムアニメーションを可能にします。
3dgs4dgshuman-avatarsingle-image -
Audio2Photoreal AIが発見
2024
対話音声から直接、自然な身体や手のジェスチャーを伴うフォトリアルな全身Codec Avatarを合成する、Metaによるオープンソースのフレームワークおよびデータセット。
audio-drivenavatarcodec-avatarfull-body -
DreamBarbie: Text to Barbie-Style 3D Avatars AIが発見
2024
テキスト指示から高品質で細部まで表現されたスタイライズドな3Dアバターを生成するフレームワーク。アニメーションや物理シミュレーションに対応した、属性が分離されたアバターを作成できます。
3d-avatarstylized-avatartext-to-3d -
DreamWaltz-G AIが発見
2024
骨格ガイド付きスコア蒸留(Score Distillation)とハイブリッド3D Gaussianアバター表現を用いて、テキストからアニメーション可能な3Dアバターを生成する学習フレームワーク。
3dgsavatardiffusiontext-to-3d -
Duix-Mobile AIが発見
2024
モバイルデバイスや組み込みスクリーン上にリアルタイムでインタラクティブなAIアバターを直接デプロイするためのオープンソースSDK。低遅延のオンデバイス展開をサポートし、開発者がLLM、ASR、TTSサービスを統合して自然な対話を実現できます。
avatarinteractiveon-devicesdk -
Duix.Avatar AIが発見
2024
短い動画入力から外見と音声をクローンできる、オープンソースの完全オフラインAIデジタルヒューマンツールキット。高いプライバシーと低遅延で、テキストから動画への変換や音声駆動のリップシンク動画生成をサポートします。
avatarcloningdigital-humanoffline -
ExAvatar AIが発見
2024
SMPL-Xと3D Gaussian Splattingを組み合わせることで、短い単一カメラのビデオから、体、顔、手を含む表現豊かな全身の3Dアバターを再構成する手法。
3dgsavatarsmpl-xwhole-body -
From Audio to Photoreal Embodiment: Synthesizing Humans in Conversations (Audio2Photoreal) AIが発見
2024
対話音声に応じて自然に身振り手振りを交えて動く、フォトリアルな全身3Dアバター(Codec Avatars)を合成するフレームワーク。
audio-drivenavatarcodec-avatarmotion-synthesis -
Human-3Diffusion AIが発見
2024
2D拡散モデルと3D Gaussian Splattingを統合することで、単一のRGB画像からリアルでアニメーション可能な3Dアバターを生成する、3D一貫性を持つ拡散モデル。
3dgsavatardiffusionreconstruction -
IDOL: Instant Photorealistic 3D Human Creation from a Single Image AIが発見
2024
単一の画像から高精度かつアニメーション可能な3Dヒューマンアバターを再構成する、フィードフォワードトランスフォーマーベースのフレームワーク。統一空間における3Dガウシアン表現を予測し、1K解像度での即時再構成とシームレスなアニメーションを可能にします。
3d-gaussiananimatableavatarreconstruction -
One Shot, One Talk: Whole-body Talking Avatar from a Single Image AIが発見
2024
単一の画像から全身のトーキングアバターを構築するパイプライン。ポーズ誘導型ビデオ生成モデルと3Dガウシアン・スプラッティングを活用し、リアルなジェスチャーと自然な表情変化を実現する。
3dgsavatarone-shottalking-head -
PuzzleAvatar AIが発見
2024
日常の写真コレクション(アルバム)から、外観やアイデンティティの特徴をトークン化して統合し、高品質でパーソナライズされた3Dアバターを生成するフレームワーク。
3d-avataravatar-generationclothed-humanreconstruction -
UltrAvatar AIが発見
2024
テキストプロンプトまたは1枚の画像から、高品質なPBRテクスチャを備えたアニメーション可能なリアルな3Dアバターを生成する、拡散モデルベースのフレームワーク。
3d-avataravatar-generationdiffusionpbr-textures -
X-Oscar: A Progressive Framework for High-quality Text-guided 3D Animatable Avatar Generation AIが発見
2024
テキストプロンプトから高品質でアニメーション可能な3Dアバターを生成する段階的フレームワーク。「形状 → テクスチャ → アニメーション」の順次パラダイムに従うことで最適化を簡素化し、過飽和を防ぎながら、リアルな質感と滑らかなアニメーションを持つ高精度なアバターを生成します。
3d-generationanimatableavatartext-to-3d -
X-Portrait AIが発見
2024
階層的なモーションアテンションを使用し、表現力豊かで時間的一貫性のあるポートレートアニメーションを生成するために設計された革新的な条件付き拡散モデル。
avatardiffusionportrait-animation -
3DGS-Avatar: Animatable Avatars via Deformable 3D Gaussian Splatting AIが発見
2023
単眼ビデオから変形可能な3D Gaussian Splattingを用いてアニメーション可能なヒューマンアバターを作成する手法。高速なトレーニングとリアルタイムレンダリングにより、高品質な新規ビューおよび新規ポーズの画像合成を実現します。
3d-avataranimatablegaussian-splattingreal-time -
Animatable Gaussians: Learning Pose-dependent Gaussian Maps for High-fidelity Human Avatar Modeling AIが発見
2023
Animatable Gaussiansは、少数のRGB動画から姿勢依存の2Dガウシアンマップを学習することで、高精細な全身ヒューマンアバターを構築する手法です。2D CNNと3D Gaussian Splattingを組み合わせることで、衣服の動的な変形や細かい形状をリアルにレンダリングします。
3d-avataranimatable-avatargaussian-splattinghuman-modeling -
DreamAvatar: Text-and-Shape Guided 3D Human Avatar Generation via Diffusion Models AIが発見
2023
テキストと形状のガイドを用いて、ポーズ制御可能な高品質3Dヒューマンアバターを生成するフレームワーク。学習可能なNeRFで密度と色を予測し、事前学習済みの2Dテキスト画像拡散モデルを活用して生成プロセスをガイドします。
3d-avatardiffusionnerftext-to-3d -
GaussianAvatars AIが発見
2023
3D Gaussian Splattingをパラメトリックなモーファブルフェイスモデルにリギングすることで、表情、ポーズ、視点を完全に制御可能なフォトリアルな3Dヘッドアバターを作成する手法。
3dmmfacial-expressiongaussian-splattinghead-avatar -
2022
CLIPでニューラル人体モデルを誘導し、テキストからゼロショットで3Dアバターを生成・アニメーション化する初期のフレームワーク。
avatartext-driven

商用・業界ツール
-
MetaHuman AIが発見
2024
MetaHumanは、Unreal Engine内で完全リグ済みのリアルなデジタルヒューマンアバターを作成・編集できるEpic Gamesのフレームワークです。顔のパーツや体型、衣装をリアルタイムでカスタマイズし、ゲーム制作に適した3Dキャラクターリグを出力できます。
digital-humanmetahumanrigged-avatarunreal-engine -
Avaturn AIが発見
2023
1枚の自撮り写真から、リアルで完全にリギングされたカスタマイズ可能なゲーム向け3Dアバターを生成するAI搭載アバター作成ツール。
3davatargame-readyrigged -
Didimo Popul8 AIが発見
2023
ゲーム開発者向けに設計されたジェネレーティブAIキャラクター作成プラットフォーム。高品質でゲームにすぐに使用できる3DアバターやNPCを即座に生成、編集、スケールアップできる。
3d-avataravatargame-readynpc -
Popul8 AIが発見
2023
ゲームスタジオ向けに設計されたDidimoのAI搭載キャラクター作成プラットフォーム。数百のユニークでゲーム対応の3DアバターやNPCを大規模に生成、編集、管理できる。
avatarcharacter-generationgame-devnpc -
Meshcapade Me AIが発見
2021
SMPLボディモデルをベースに構築されたAI搭載プラットフォームで、写真、ビデオ、または身体測定値から、高精度で業界標準の3D人間アバターを生成します。
3d-avatarbody-measurementdigital-humansmpl -
HeyGen AIが発見
2020
テキストスクリプトからプロフェッショナルな動画を作成するために、非常にリアルなトーキングアバターと音声クローンを使用する、業界大手の商用AI動画生成プラットフォーム。
avatarcommercialtalking-headvideo-generation -
Meshcapade AIが発見
2020
SMPLボディモデルを使用し、写真、動画、または3Dスキャンからリアルな3D人間アバターとモーションキャプチャデータを生成するAI搭載プラットフォーム。
3d-avataravatarsmpl -
Unreal Engine向けに、フルリグ済みでフォトリアルなデジタルヒューマンを作成するEpicのツール。ゲームのキャラクターや映像表現の業界標準。
commercialriggedunreal