3Dシーン・環境生成
3D生成
オープンソース
-
DreamX-World 1.0 AIが発見
2026
制御可能な長期の3Dシーン生成を可能にする、汎用的なインタラクティブ型Text/Image-to-Video世界モデル。フォトリアル、ゲームスタイル、様式化されたドメインにわたり、カメラナビゲーション、過去に観測した領域への再訪問、プロンプトによるイベント発生などをサポートします。
interactivescene-generationworld-model -
Gen3R: 3D Scene Generation Meets Feed-Forward Reconstruction AIが発見
2026
基盤再構成モデルとビデオ拡散モデルを融合させ、シーンレベルの3D生成において、RGBビデオとそれに対応する3Dジオメトリ(カメラ軌跡を含む)を同時に生成する手法。
3d-scenereconstructionvideo-diffusion -
Lyra 2.0 AIが発見
2026
NVIDIAが開発したLyra 2.0は、1枚の画像や動画のウォークスルーから、永続的で探索可能な大規模3Dワールドを生成するフレームワーク。長いカメラ軌道における空間的な忘却や時間的なドリフトに対処し、リアルタイムレンダリングに対応した3D一貫性のある環境を構築する。
3d-sceneconsistencyvideo-to-3dworld-model -
minWM AIが発見
2026
リアルタイムのインタラクティブなビデオ世界モデル向けに設計された、フルスタックのオープンソースフレームワークおよびチュートリアル。データ構築、制御可能な微調整、自己回帰トレーニング、少数ステップの蒸留、ストリーミング推論にわたる完全なパイプラインを提供します。
interactivereal-timeworld-model -
OpenWorldLib: A Unified Codebase and Definition of Advanced World Models AIが発見
2026
インタラクティブなビデオ生成、3Dシーン生成、マルチモーダル推論、およびVision-Language-Action(VLA)モデルなどのタスクを標準化する、統合された世界モデル推論フレームワーク。
3d-sceneframeworkworld-model -
PixWorld: Unifying 3D Scene Generation and Reconstruction in Pixel Space AIが発見
2026
ピクセル空間で直接動作する、3Dシーン生成と再構成の統一フレームワーク。潜在空間エンコーディングによる情報損失を回避することで、事前学習済みのVAEを必要とせずに、高忠実度な3Dシーンの合成と再構成を実現します。
environmentpixel-spacereconstructionscene -
SAGE AIが発見
2026
任意のユーザープロンプトから、シミュレーション対応で現実的かつ物理的に安定した3D環境を自動生成するNVIDIAのエージェント型フレームワーク。レイアウトやオブジェクトの生成器と、意味的妥当性・視覚的リアルさ・物理的安定性を評価するクリティックを組み合わせ、自己修正を繰り返しながらシーンを構築します。
agenticembodied-ailayoutscene-generation -
SceneAssistant: A Visual Feedback Agent for Open-Vocabulary 3D Scene Generation AIが発見
2026
オープンボキャブラリの3Dシーン合成向けに設計された、視覚フィードバック駆動型のエージェントフレームワークであり、一連のアクションAPIを利用してシーンのレイアウトを反復的に洗練する。
3d-generationagenticopen-vocabularyscene-generation -
SceneFoundry: Generating Interactive Infinite 3D Worlds AIが発見
2026
機能的に可動する家具やセマンティックに多様なレイアウトを備えた、アパートメントスケールの3D環境を生成する言語誘導型拡散フレームワーク。LLMによる間取り図生成と拡散モデルベースの配置により、物理的な実用性とナビゲーション可能性を保証します。
embodied-aienvironmentinteractivescene -
SynCity 3000 AIが発見
2026
画像から3Dへの生成器を畳み込み演算子として適応させることで、きめ細かなレイアウト制御を伴うグローバルに一貫した3Dシーンを生成するフレームワーク。新しい合成データエンジンで微調整を行うことで、シーンスケールのトレーニングデータの不足に対処します。
3d-diffusionscene-scalesynthetic-data -
WorldClaw: Agentic 3D Open-World Generation at Scale AIが発見
2026
テキストプロンプトから大規模で編集可能な3Dオープンワールドを生成する、エージェント指向の粗から密へのフレームワーク。プランニングエージェントがテキストを領域、地形、アセット、マテリアル、空間関係の構造化仕様に変換し、グローバルに一貫した3Dシーンを構築します。
agenticenvironmentopen-worldscene -
WorldFlow3D: Flowing Through 3D Distributions for Unbounded World Generation AIが発見
2026
フローマッチングを用いて3Dデータ分布をモデル化し、大規模な屋外および屋内シーンの合成を可能にする、完全な制御性を備えた無限の3Dワールド生成フレームワーク。
3d-generationflow-matchingscene-generationunbounded-world -
BloomScene AIが発見
2025
テキストや画像から高品質な3Dシーンを生成する、軽量かつ構造化された3D Gaussian Splattingフレームワーク。従来の3Dシーン生成におけるストレージ容量の肥大化や幾何学的歪みの課題を解決します。
3dgsimage-to-3dscene-generationtext-to-3d -
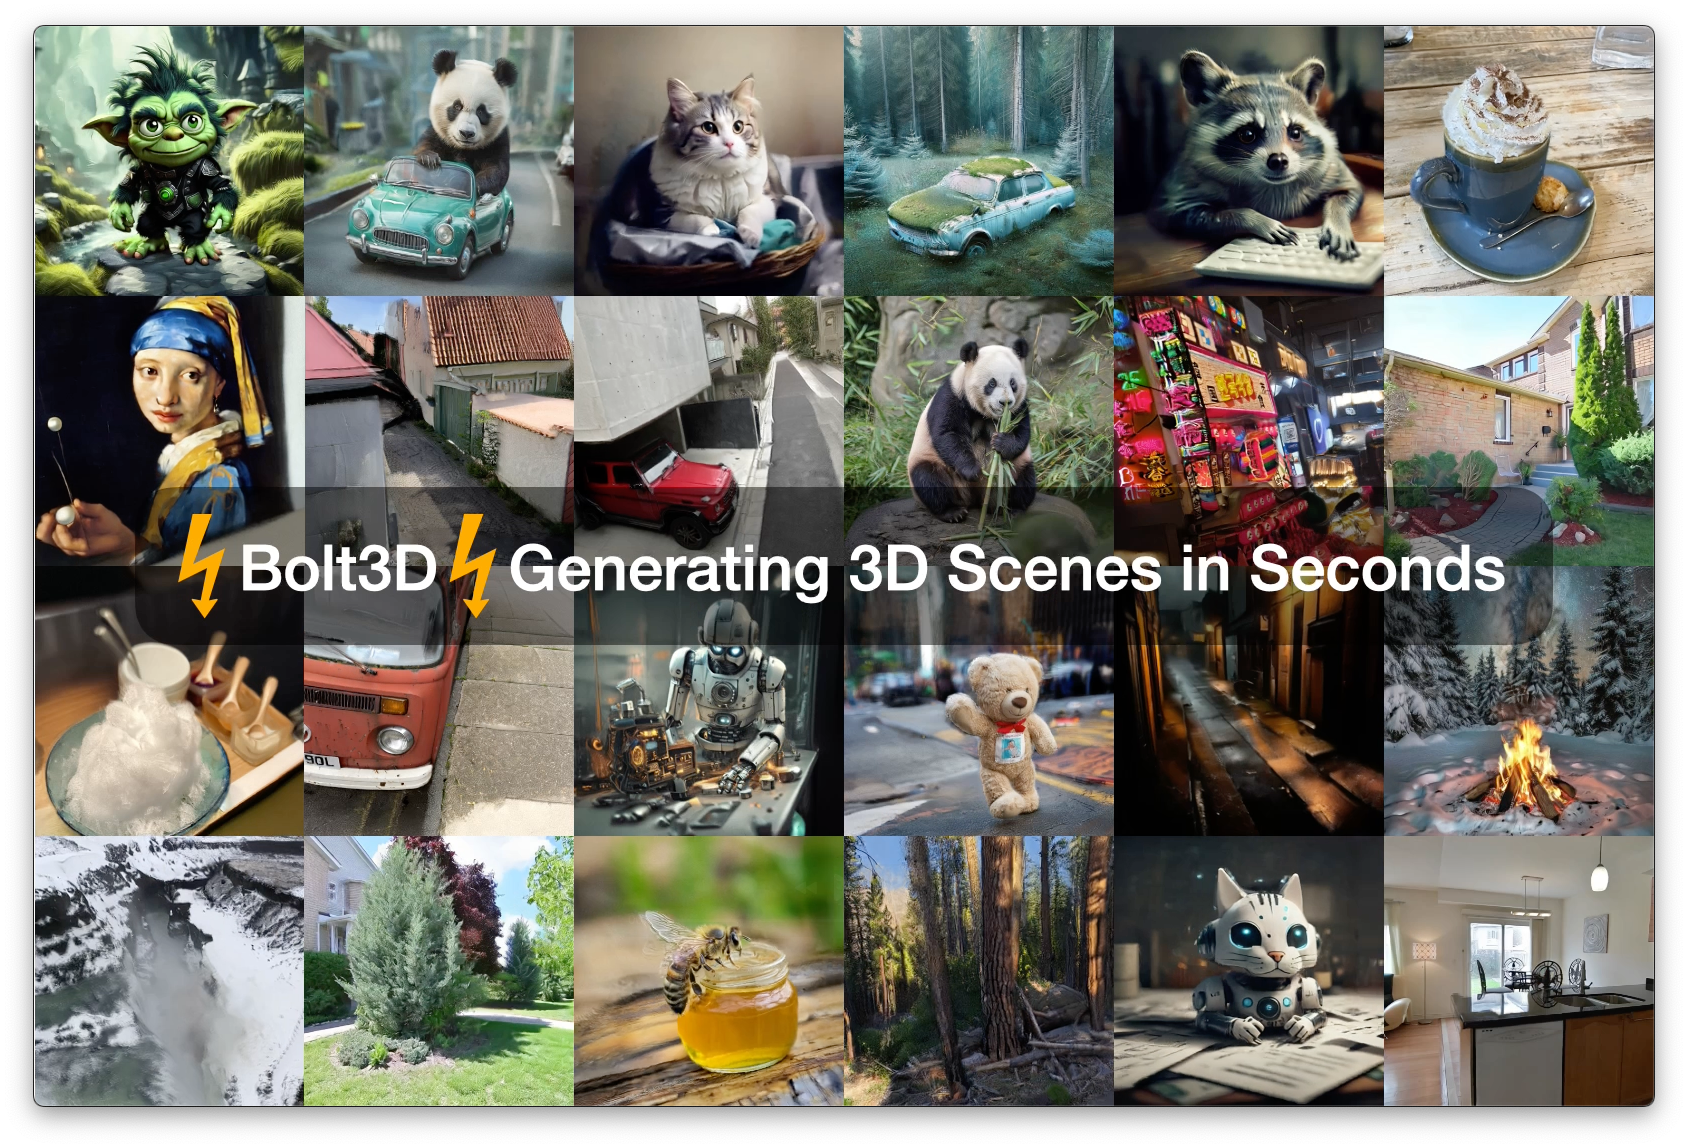
Bolt3D AIが発見
2025
単一のGPU上で7秒未満で3Dシーン表現を直接サンプリングする、高速なフィードフォワード3Dシーン生成向け潜在拡散モデル。スケーラブルな2D拡散ネットワークアーキテクチャを活用し、一貫性のある高精度なマルチビューのスプラッター画像を生成して、完全な3Dガウシアンシーンを構築する。
diffusionfast-generationfeed-forwardgaussian-splatting -
FlashWorld AIが発見
2025
単一の画像またはテキストプロンプトから、わずか数秒で高品質な3Dシーンを生成する高速モデル。マルチビュー指向の拡散モデルから3D一貫性のあるマルチビュー生成モデルへ視覚的忠実度を転送する、クロスモード事後学習蒸留戦略を採用しています。
3dgsfast-generationimage-to-3dtext-to-3d -
FreeScene: Mixed Graph Diffusion for 3D Scene Synthesis from Free Prompts AIが発見
2025
視覚言語モデルベースのグラフデザイナーと生成型混合グラフ拡散トランスフォーマー(MG-DiT)を統合し、テキスト、図、スケッチなどの自由形式のユーザー入力に対応する、使いやすく制御可能な屋内シーン合成フレームワーク。
3d-scenediffusionindoor-synthesis -
HOLODECK 2.0: Vision-Language-Guided 3D World Generation with Editing AIが発見
2025
人間のフィードバックに基づくインタラクティブなシーン編集をサポートし、多様なスタイルの3D環境を生成できる、高度な視覚と言語ガイド付きの3Dワールド生成フレームワーク。
3d-scenediffusionenvironment -
HunyuanWorld 2.0 (HY-World-2.0)
2025
Tencent Hunyuanによるオープンな3Dワールド生成モデル。テキストや画像のプロンプトから探索可能で没入感のある3Dシーン・ワールドを生成する。
open-weightsscene-generationworld-model -
Lyra: Generative 3D Scene Reconstruction via Video Diffusion Model Self-Distillation AIが発見
2025
カメラ制御ビデオ拡散モデルから得られる暗黙的な3D知識を、明示的な3Dガウシアン・スプラッティング(3DGS)表現へと蒸留する3D/4Dシーン再構成フレームワーク。テキスト、単一画像、または単眼ビデオから、探索可能な3D環境の生成を可能にします。
3d-scenegaussian-splattingvideo-diffusionworld-model -
MAGIC: Multi-scene Automated Gameworlds Generation with Intelligent Connectivity AIが発見
2025
大規模言語モデル(LLM)を用いて、インテリジェントな接続性を持つマルチシーンのゲームワールドを自動生成するフレームワーク。シーン計画、構成、UnityおよびBlenderとの統合をサポートします。
blendergameworldsceneunity -
Matrix-3D: Omnidirectional Explorable 3D World Generation AIが発見
2025
条件付きビデオ生成とパノラマ再構成を組み合わせ、広範囲かつ全方位に探索可能な3D世界を単一の画像やテキストプロンプトから生成するフレームワーク。
3d-scenepanoramaworld-generation -
MMGDreamer: Mixed-Modality Graph for Geometry-Controllable 3D Indoor Scene Generation AIが発見
2025
混合モダリティグラフ、視覚的エンハンスメント、および関係予測を利用して、オブジェクトの幾何学的形状を精密に制御する、制御可能な3D屋内シーン生成のためのデュアルブランチ拡散フレームワーク。
3d-scenediffusionindoor-synthesis -
Scene Splatter: Momentum 3D Scene Generation from Single Image with Video Diffusion Model AIが発見
2025
ビデオ拡散モデルを用いて単一の画像から一般的な3Dシーンを生成する、モメンタムベースのパラダイム。過去のフレームからノイズを含むサンプルを構築することで、新規ビュー合成におけるビデオの長さの制限やシーンの不整合を解消し、安定した高品質な3D再構成を可能にする。
diffusiongaussian-splattingscene-generationvideo-diffusion -
SceneGen AIが発見
2025
単一のシーン画像と対応するオブジェクトマスクから、複数の3Dアセットを一度のフィードフォワード処理で生成するフレームワーク。最適化やアセット検索を必要とせず、複数のオブジェクトの形状、テクスチャ、および相対的な空間配置を同時に出力します。
feedforwardimage-to-3dmulti-objectscene-generation -
ScenePainter: Semantically Consistent Perpetual 3D Scene Generation with Concept Relation Alignment AIが発見
2025
単一の画像から長範囲で一貫した3Dビューシーケンスを生成する、永続的な3Dシーン生成のためのフレームワーク。シーンコンセプトグラフで表現された概念関係とアウトペインティングモデルのシーン固有の事前分布を整合させることで、セマンティックドリフト(意味の逸脱)の問題を解決する。
outpaintingperpetual-scenescene-generationscene-graph -
Scenethesis: A Language and Vision Agentic Framework for 3D Scene Generation AIが発見
2025
LLMによるシーン計画とビジョン誘導型のレイアウト洗練を組み合わせ、多様で現実的、かつ物理的に妥当なインタラクティブ3Dシーンを生成する、学習不要のエージェント型フレームワーク。最適化モジュールを用いて正確なポーズ調整と物理的安定性を確保します。
agentenvironmentlayoutscene -
SpatialGen AIが発見
2025
マルチビュー・マルチモーダル拡散モデルを活用し、テキストまたは画像プロンプトからフォトリアルな3D屋内シーンを合成する、レイアウトガイド付き3Dシーン生成フレームワーク。
diffusionindoor-scenelayout-guided -
2025
生成された形状を最初に観測された領域を超えて段階的に拡張・成長させることで、大規模で一貫した3Dシーンを生成する。
3d-scenediffusionscene-generation -
3D-SceneDreamer AIが発見
2024
生成モデルを活用して一貫した3D環境を作成することにより、幾何学と外観の誤差累積を解消する、テキスト駆動型の3D一貫シーン生成フレームワーク。
consistencyscene-generationtext-to-3d -
BlockFusion: Expandable 3D Scene Generation using Latent Tri-plane Extrapolation AIが発見
2024
3Dシーンを単位ブロックとして生成し、新しいブロックをシームレスに結合してシーンを無限に拡張できる拡散ベースのモデル。潜在トライプレーン表現と外挿メカニズムを利用して、ブロック境界を越えた幾何学的およびスタイル的な一貫性を確保する。
diffusioninfinite-worldscene-generationtri-plane -
Director3D AIが発見
2024
テキストプロンプトからリアルな3Dシーン(3D Gaussian Splattingを使用)とカメラ軌道の両方を生成する、実世界のデータセット向けに設計されたテキストto 3D生成フレームワーク。
gaussian-splattingscene-generationtext-to-3d -
DreamScene360 AIが発見
2024
平面パノラマ画像をセマンティックおよび幾何学的な制約を伴う3D Gaussian Splatting表現に変換することで、没入感のある360度環境を構築するテキストからの3Dシーン生成パイプライン。
3d-scenegaussian-splattingpanorama -
DreamScene: 3D Gaussian-based Text-to-3D Scene Generation via Formation Pattern Sampling AIが発見
2024
Formation Pattern Sampling (FPS) と段階的なカメラサンプリング戦略を利用して、高品質で一貫性があり、編集可能な屋内・屋外環境を生成する、3D Gaussian Splattingベースのテキストto3Dシーン生成フレームワーク。
3d-scenegaussian-splattingtext-to-3d -
EchoScene: Indoor Scene Generation via Information Echo over Scene Graph Diffusion AIが発見
2024
シーングラフに基づいてインタラクティブかつ制御可能な3D屋内シーンを生成する拡散モデル。形状とレイアウトの生成をグローバルな制約下で調整する情報エコー(Information Echo)スキームを備えたデュアルブランチ拡散モデルを採用しています。
3d-scenediffusion-modelscene-graph -
Frankenstein: Generating Semantic-Compositional 3D Scenes in One Tri-Plane AIが発見
2024
単一のパスでセマンティック構成要素に分解された3Dシーンを生成する拡散ベースのフレームワーク。単一のトライプレーンテンソルから複数の符号付き距離関数(SDF)をデコードすることで、個別に編集や再配置が可能な、セマンティックに意味のある複数の独立した形状を同時に生成できる。
compositionaldiffusionscene-generationsdf -
InstructScene: Instruction-Driven 3D Indoor Scene Synthesis with Semantic Graph Prior AIが発見
2024
意味論的グラフ事前分布とレイアウトデコーダを統合することで、自然言語の指示から3D屋内シーンを合成し、制御性と忠実度を大幅に向上させる生成フレームワーク。
3d-scenediffusionindoor-synthesis -
MIDI AIが発見
2024
単一画像から構成的な3Dシーンを生成するために設計されたマルチインスタンス拡散モデル。正確な空間関係を持つ複数の高品質な3Dオブジェクトを同時に生成することを可能にします。
3d-scenediffusionimage-to-3dmulti-instance -
PhyScene: Physically Interactable 3D Scene Synthesis for Embodied AI AIが発見
2024
衝突、レイアウト、到達可能性の制約を組み込むことで、可動オブジェクトを含むリアルなレイアウトを生成する、物理的にインタラクティブな3Dシーン合成用のガイド付き拡散モデル。
3d-generationdiffusion-modelphysics-constraintsscene-generation -
RealmDreamer AIが発見
2024
事前学習済みの2D画像条件付き拡散モデルと深度拡散モデルを用いて3D Gaussian Splatting表現を最適化することにより、テキスト記述から一般的な前方3Dシーンを生成する手法。
3dgsinpaintingscene-generationtext-to-3d -
SceneCraft AIが発見
2024
自由なレイアウトと視点条件に基づいて複雑な3Dシーンを生成する、レイアウトガイド付き3Dシーン生成フレームワーク。拡散モデルベースのパイプラインにより、空間的一貫性と高品質なジオメトリを実現します。
3d-scenediffusionlayout-guided -
SceneDreamer360: Text-Driven 3D-Consistent Scene Generation with Panoramic Gaussian Splatting AIが発見
2024
パノラマ画像生成と3D Gaussian Splatting (3DGS) を活用し、360度ビューを持つ高品質で空間的に一貫した3D環境を合成する、テキスト駆動型の3Dシーン生成フレームワーク。
3d-scenegaussian-splattingpanoramatext-to-3d -
SceneTeller AIが発見
2024
自然言語の記述から高品質な屋内3Dシーンを生成し、インタラクティブな部屋のプランニングや環境デザインを容易にする、テキストベースの3Dルームデザインフレームワーク。
indoor-sceneroom-designtext-to-3d -
SceneX: Procedural Controllable Large-scale Scene Generation AIが発見
2024
大規模言語モデル(LLM)とプロシージャル・コンテンツ生成(PCG)ツールを組み合わせ、テキスト記述から高品質な3D自然景観や都市環境を自動生成する、プロシージャル制御可能な大規模シーン生成フレームワーク。
3d-scenellmpcgprocedural-generation -
WonderWorld AIが発見
2024
ユーザーが単一の画像から、接続された多様で探索可能な3D環境を低遅延かつインタラクティブに段階的生成できる3Dシーン生成フレームワーク。
3d-scenegaussian-splattinginteractive -
Ctrl-Room: Controllable Text-to-3D Room Meshes Generation with Layout Constraints AIが発見
2023
レイアウトと外観のモデリングを分離することで、デザイナーズスタイルのレイアウトを持つ高精度な3D屋内シーンを生成し、家具のサイズ変更や移動などのインタラクティブな編集操作を可能にする、制御可能なテキストto3Dルーム生成フレームワーク。
3d-sceneindoor-scenelayout-controltext-to-3d -
Holodeck AIが発見
2023
大規模言語モデル(LLM)を活用して空間配置の計画やアセットの選択を行い、自然言語のプロンプトから多様でインタラクティブな3D環境を自動生成するシステム。
3d-scenellmprocedural -
SceneDreamer AIが発見
2023
3Dアノテーションなしの野生の2D画像コレクションのみから学習し、ランダムノイズから大規模な3D景観を合成する、境界のない3Dシーン向けの無条件生成モデル。
generative-modellandscape-generationunbounded-scene


商用・業界ツール
-
World Labs Marble AIが発見
2025
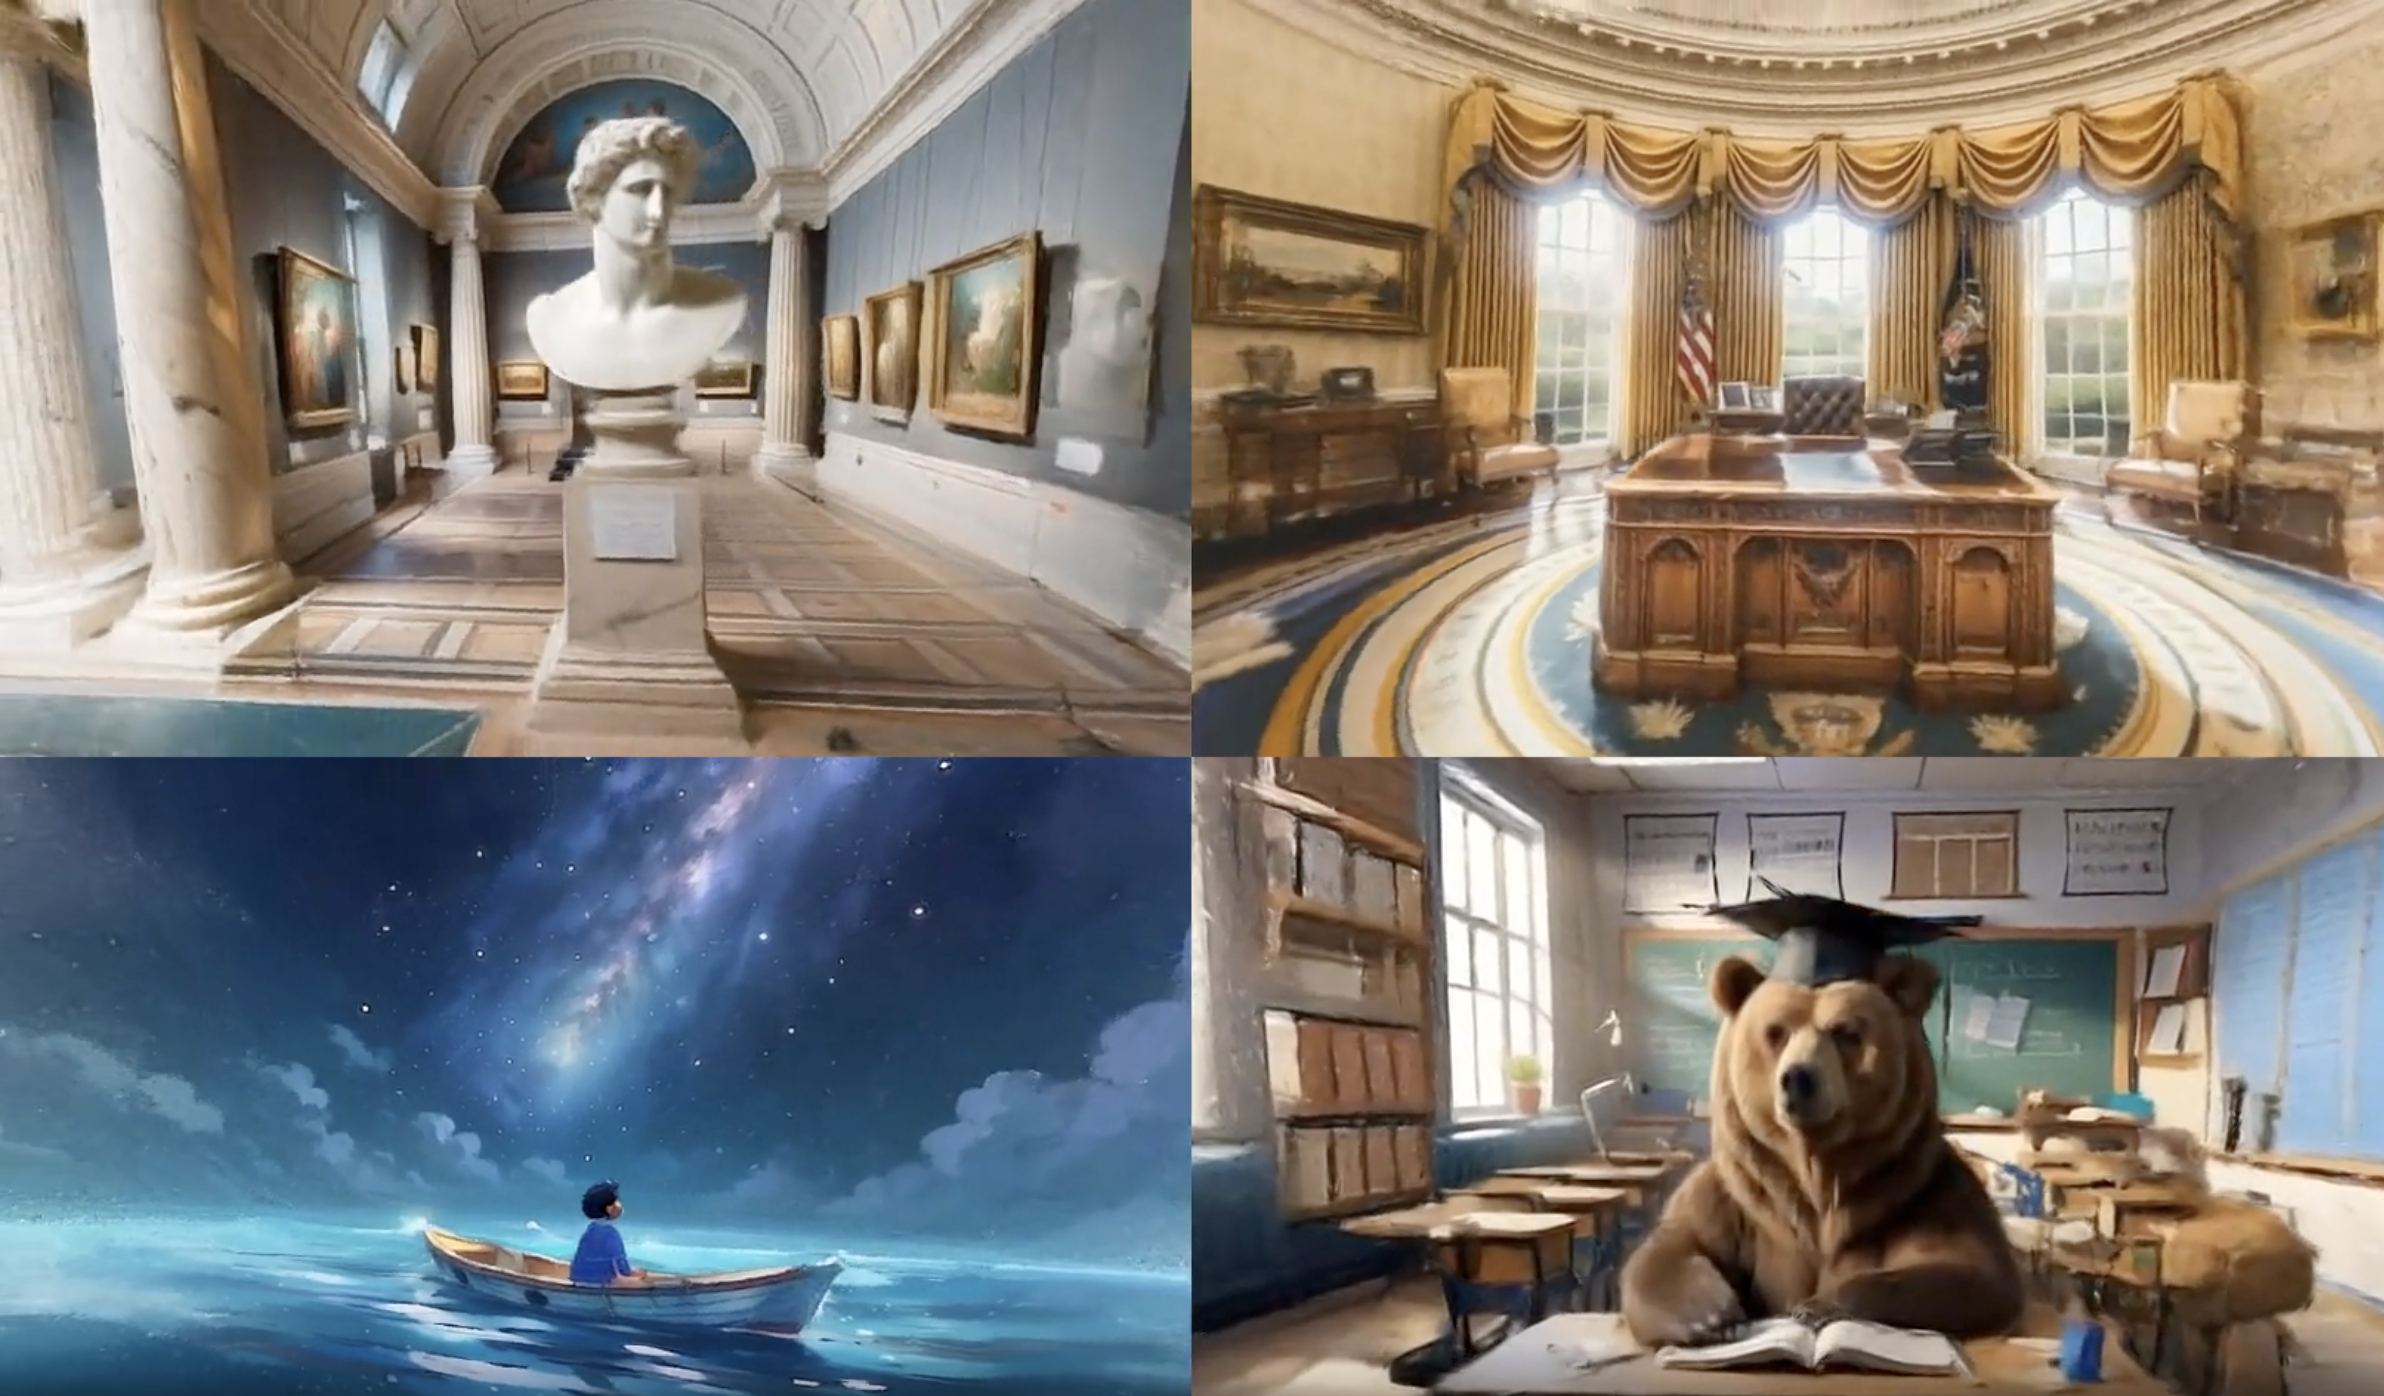
テキスト、画像、動画、または大まかなレイアウトから、永続的で高精度な3D環境を生成するマルチモーダル3Dワールドモデル。インタラクティブなカメラ制御、AIネイティブなワールド編集(オブジェクトの追加・削除、スタイル変更)、およびガウシアン・スプラッティング、メッシュ、動画としてのシーン書き出しをサポートする。
3d-sceneenvironmentgaussian-splattingworld-model -
Atlas AI Studio AIが発見
2023
2Dコンセプトアート、ムードボード、テキストプロンプトを構造化された3Dアセットや環境に変換することで、ゲーム開発者のバーチャルワールド構築を加速するジェネレーティブAIプラットフォーム。
3d-assetsconcept-to-3dworldbuilding -
Promethean AI AIが発見
2019
アーティストのアセット配置、レイアウト提案、主要ゲームエンジン内での3D環境生成を自動で支援する、バーチャルワールド構築およびセットドレス用のAI駆動型スイート。
set-dressingunreal-engineworld-building -
DeepMindの基盤ワールドモデル。単一の画像やテキストプロンプトから、リアルタイムに操作できるインタラクティブでプレイ可能な3D環境を生成する。
commercialinteractiveplayableworld-model -
World Labsによる商用プラットフォーム。プロンプトや画像から大規模で探索可能な3Dワールドを生成し、ゲームやバーチャルプロダクションの環境制作を狙う。
apicommercialsceneworld-model -
リアルタイムなワールド制作に向けて、インタラクティブで探索可能な環境を生成する新興の商用ワールドモデル。
commercialinteractiveworld-model -
プロンプトや画像から、移動・探索可能な3Dシーンやワールドを生成する新興の商用空間知能プラットフォーム。
commercialsceneworld-model