音声合成(TTS)
音声・オーディオ
オープンソース
-
Fish Audio S2 AIが発見
2026
自然言語による指示追従制御、複数話者、マルチターン生成を特徴とする、高度なオープンソース音声合成システム。段階的なデータパイプラインと報酬モデリングを活用し、最先端の多言語音声生成およびボイスクローニングを実現します。
instruction-followingmultilingualttsvoice-cloning -
Supertonic AIが発見
2026
最小限のオーバーヘッドでローカル推論を行うために設計された、超高速かつオンデバイスの多言語テキスト読み上げシステム。ONNX Runtimeを搭載し、31言語をサポートし、ゲームなどのリアルタイムアプリケーション向けに高度に最適化されています。
multilingualon-deviceonnxtts -
VoxCPM2 AIが発見
2026
階層型拡散自己回帰パラダイムに基づく、完全オープンソースの多言語・制御可能な音声生成基盤モデル。30言語、自然言語による音声デザイン、スタイル制御可能な音声クローニング、および高忠実度な48kHzオーディオ出力をサポートします。
diffusionmultilingualttsvoice-cloning -
IndexTTS AIが発見
2025
IndexTTSは、発音精度の向上のために文字と音素のハイブリッドモデリングを取り入れた、制御可能で産業グレードのゼロショットテキスト読み上げシステムです。
controllableindustrial-ttsttszero-shot -
IndexTTS2 AIが発見
2025
感情表現と発話時間の制御に対応した、産業レベルの自己回帰型ゼロショットテキスト読み上げ(TTS)システム。正確な発話時間制御と忠実な感情再現のための新しい手法を導入しており、インタラクティブな対話アプリケーションに最適です。
duration-controlemotion-controlttszero-shot -
Zonos AIが発見
2025
20万時間以上の多言語音声データで学習されたオープンウェイトのテキスト読み上げ(TTS)モデル。高い表現力、音声クローニング、話速・ピッチ・感情の精密な制御を可能にします。
speech-synthesisttsvoice-cloning -
ChatTTS AIが発見
2024
日常の対話シナリオに最適化された生成型音声モデル。複数話者によるインタラクティブな会話や、笑い声や間(ポーズ)などの自然な非言語表現をサポートします。
conversationaldialoguetts -
CosyVoice AIが発見
2024
AlibabaのFunAudioLLMチームが開発した多言語対応の大規模音声生成モデル。高品質な音声合成、ゼロショット音声クローン、感情やスタイルの詳細な制御をサポートします。
multilingualttsvoice-cloning -
CosyVoice AIが発見
2024
AlibabaのFunAudioLLMが開発した、スケーラブルな多言語ゼロショット音声合成システム。LLMによるテキストからトークンへの生成と、条件付きフローマッチングモデルによるトークンから音声への合成を組み合わせることで、高品質なボイスクローニング、クロスリンガル合成、感情制御を実現します。
flow-matchingmultilingualttsvoice-cloning -
E2 TTS AIが発見
2024
人間レベルの自然さと、最先端の話者類似性および明瞭度を提供する、完全非自動回帰型のゼロショットテキスト読み上げ(TTS)システム。フィラートークンを含む文字シーケンスで訓練されたフローマッチングベースのメルスペクトログラムジェネレータを使用し、複雑なアライメントや音素長の予測を不要にしています。
flow-matchingnon-autoregressivettszero-shot -
F5-TTS AIが発見
2024
Flow MatchingとConvNeXt V2を採用したDiffusion Transformer(DiT)に基づく非自己回帰型テキスト読み上げシステム。極めて自然で表現力豊かなゼロショット音声クローンを高速に生成します。
diffusionttsvoice-cloning -
FireRedTTS AIが発見
2024
産業レベルの生成音声アプリケーション向けに設計された基盤テキスト読み上げ(TTS)フレームワーク。堅牢なデータ処理パイプライン、テキストをセマンティックトークンにマッピングするTTS言語モデル、およびフローマッチングに基づくメルスペクトログラムデコーダを備え、非常に自然でパーソナライズされた音声合成を実現します。
flow-matchingfoundation-modelspeech-synthesistts -
Fish Speech AIが発見
2024
大規模言語モデルとDual-Autoregressiveアーキテクチャを活用し、極めて自然で感情豊かな音声生成とゼロショットクローンを実現する、最先端の多言語テキスト読み上げシステム。
multilingualttsvoice-cloning -
Fish Speech AIが発見
2024
VQ-GANとLLMの2段階アーキテクチャに基づき、ゼロショット音声クローニングと極めて表現豊かな多言語音声合成をサポートする最先端のオープンソーステキスト読み上げ(TTS)システム。
speech-synthesisttsvoice-cloning -
GPT-SoVITS AIが発見
2024
わずか1分間の音声データで高精度な音声クローンを作成できる、強力なフューショット音声変換およびテキスト読み上げ(TTS)システム。ゼロショット推論や多言語合成に対応しています。
few-shotttsvoice-cloning -
Kokoro AIが発見
2024
8200万パラメータを持つ極めて軽量かつ効率的なオープンウェイトのテキスト読み上げモデル。複数の言語にわたり、スタジオクオリティの自然な音声を高速に生成します。
lightweightmultilingualtts -
Parler-TTS AIが発見
2024
Hugging Faceによるオープンソースのテキスト読み上げ(TTS)モデルおよび学習ライブラリ。性別、背景ノイズ、話速、ピッチなどを自然言語のプロンプトで指定し、高品質で自然な音声を制御・生成できる。
speech-synthesisttsvoice-generationGitHub · arXiv · Hugging Face
-
Parler-TTS AIが発見
2024
自然言語のプロンプトによって制御され、高品質で自然な音声を生成する、軽量かつ完全にオープンソースのテキスト読み上げ(TTS)モデルおよび学習フレームワーク。
open-sourcespeech-synthesistts -
Style-Bert-VITS2 AIが発見
2024
制御性の高い音声スタイルや感情表現を導入したBert-VITS2の拡張版。キャラクターボイス生成用として、アニメやゲーム開発コミュニティで広く採用されています。
anime-voicestyle-controlttsvits2 -
EmotiVoice AIが発見
2023
NetEase Youdaoによる、マルチボイスおよびプロンプト制御対応の音声合成エンジン。感情やスタイルを細かくコントロールした、表現力豊かな音声合成をサポートする。
emotional-speechneteaseprompt-controltts -
Matcha-TTS AIが発見
2023
条件付きフローマッチング(CFM)に基づく、高速・軽量かつ高品質な非自己回帰型テキスト読み上げ(TTS)アーキテクチャ。少ないステップ数で迅速な音声合成を実現する。
fast-inferenceflow-matchingtts -
MeloTTS AIが発見
2023
MyShellが開発した、高品質かつ軽量で極めて高速な多言語テキスト読み上げライブラリ。英語、スペイン語、フランス語、中国語、日本語、韓国語に対応しています。
lightweightmultilingualtts -
StyleTTS 2 AIが発見
2023
スタイル拡散(Style Diffusion)と大規模音声言語モデルを用いた敵対的学習により、人間レベルの極めて自然な音声合成を実現する先進的なテキスト読み上げモデル。
style-diffusionttsvoice-cloning -
StyleTTS 2 AIが発見
2023
スタイル拡散(Style Diffusion)と大規模音声言語モデルを用いた敵対的学習を活用し、人間レベルの自然な音声を合成するテキスト読み上げ(TTS)モデル。
diffusionspeech-synthesistts -
TorToiSe TTS AIが発見
2023
品質とリアルな韻律(プロソディ)に重点を置いて大規模データセットで訓練された、表現力豊かな多音声テキスト読み上げシステム。自己回帰トランスフォーマーと拡散モデルを活用して、極めて自然な音声を生成します。
diffusiontransformerttsvoice-cloning -
VALL-E X AIが発見
2023
ゼロショットのクロスリンガルテキスト読み上げおよび音声クローニングのための、Microsoftのクロスリンガルニューラルコーデック言語モデルのオープンソース実装。異なる言語の短い音声プロンプトを使用して、話者の声を維持しながらターゲット言語の音声を合成できます。
codeccross-lingualttsvoice-cloning -
2021
変分推論と敵対的学習を組み合わせたエンドツーエンドの音声合成モデル。多くのオープンな日本語・キャラクター音声の基盤。
end-to-endtts -
VOICEVOX AIが発見
2021
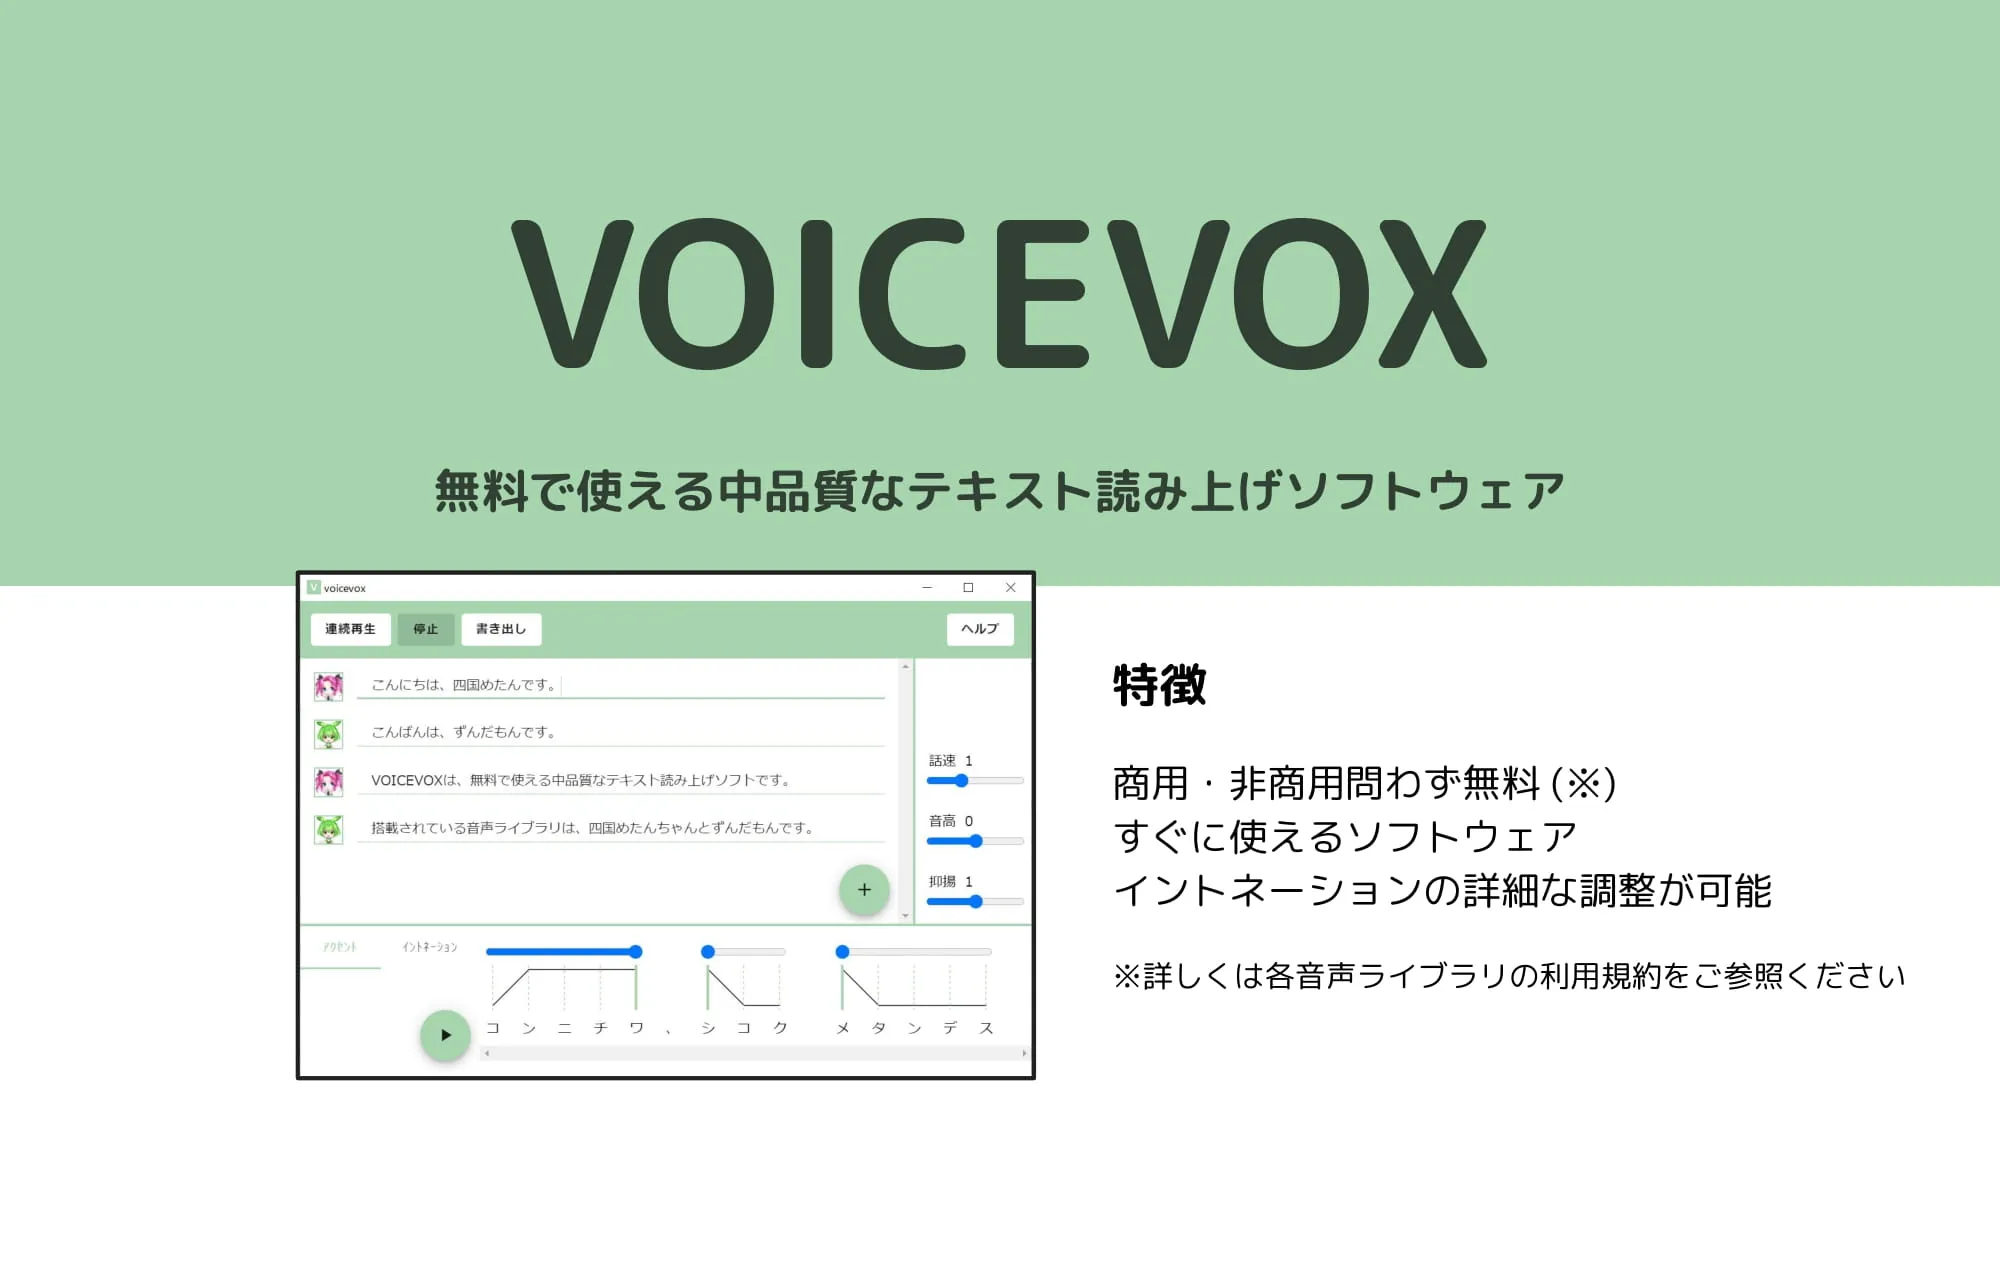
VOICEVOXは、ゲーム開発やVTuberコンテンツ制作、アニメ制作で広く利用されているオープンソースの日本語テキスト読み上げエディタおよび合成エンジンです。
japanesespeech-synthesisttsvoicevox

商用・業界ツール
-
Cartesia AIが発見
2024
Sonicモデルを搭載した最先端のリアルタイムテキスト読み上げプラットフォーム。100ミリ秒未満の超低遅延と、インタラクティブなアプリケーションやAIエージェント向けの極めて表現力豊かな音声を提供します。
low-latencyreal-timetts -
Resemble AI AIが発見
2019
高精度なテキスト読み上げ、リアルタイム音声クローン、および透かし埋め込み技術を統合したディープフェイク検出機能を提供する、エンタープライズ向けの生成音声プラットフォーム。
enterprisettsvoice-cloning -
Respeecher AIが発見
2018
ハリウッド映画やAAAゲーム制作で広く使用されている、エンタープライズ向けの音声クローニングおよび音声合成プラットフォーム。高い感情再現度で音声を複製・変換します。
game-productionspeech-synthesisvoice-cloningvoice-conversion -
表現力豊かなTTS、ボイスクローン、ダビング、効果音を提供する商用音声プラットフォーム。ゲーム・アニメのボイスオーバーで広く採用されている。
apicommercialdubbingvoice-cloning