テキスト→モーション
アニメーション・モーション
オープンソース
-
ARDY AIが発見
2026
テキストプロンプトや運動学的制約から、リアルタイムかつインタラクティブに3D人間の動作を生成するために設計された、ハイブリッド表現を用いた自己回帰型拡散フレームワーク。
autoregressiveinteractivemotion-generation -
DrawMotion AIが発見
2026
従来のテキストプロンプトとフリーハンドの手描きスケッチの両方から3D人間のモーションを生成し、正確なセマンティックおよび空間的制御を提供する拡散ベースのフレームワーク。
motion-generationsketch-to-motiontext-to-motion -
FRoM-W1 AIが発見
2026
自然言語の指示を用いて、人型ロボットの全身モーション制御および実行を実現するために設計されたオープンソースのフレームワーク。
humanoidmotion-generationtext-to-motion -
HandX AIが発見
2026
テキストから両手の動作や器用な手と物体の相互作用の生成をスケーリングするための統一された基盤モデルおよびデータセット。詳細な指のダイナミクスや接触のタイミングを捉えます。
bimanualdexterous-interactionhand-motion -
Kimodo AIが発見
2026
テキストプロンプトや運動学的制約から人間の動作生成をスケールアップする、NVIDIAが開発した表現力豊かで制御可能な運動学的モーション拡散モデル。
diffusionmotion-generationtext-to-motion -
KV-Control AIが発見
2026
元のモーション事前学習モデルを維持しつつ、特定の経路や関節の軌道に沿ってキャラクターを誘導するために、キー/値アテンションバイアスを注入するテキストからのモーション生成用のパラメータ効率の良い軌道制御メカニズム。
motion-generationtext-to-motiontrajectory-control -
LaMoGen: Language to Motion Generation Through LLM-Guided Symbolic Inference AIが発見
2026
LLM誘導型のシンボリック推論と、LabanLiteと呼ばれる身体部位レベルのシンボリック表現を利用したテキストからモーションへの生成フレームワークです。自然言語の指示を、精密で説明可能かつ時間的に正確な人間の動作に変換します。
explainable-aillmmotion-generationsymbolic-inference -
MoLA-Align: Exploring Motion-Language Alignment for Text-driven Motion Generation AIが発見
2026
MoLA-Alignは、テキスト駆動型モーション生成におけるモーションと言語のアライメントを探求し、テキスト記述と3D人間のモーションシーケンスを整合させる堅牢なフレームワークを構築します。これにより、生成されるアニメーションのセマンティックな一貫性と物理的な妥当性が向上します。
alignmentmotion-generationtext-to-motion -
MoScale: Next-Scale Autoregressive Models for Text-to-Motion Generation AIが発見
2026
3Dの人体モーションを粗い時間解像度から細かい時間解像度へと階層的に生成する、ネクストスケール自己回帰フレームワーク。最も粗いスケールでグローバルな意味論を提供し、それを段階的に洗練させることで、長時間のモーション構造に適した因果的階層を構築します。
autoregressivehierarchicalmotion-generationtext-to-motion -
MotionHiFlow AIが発見
2026
階層的フローマッチングを利用して複数の時間スケールで人間の動きをモデル化し、セマンティックな整合性と時間的な一貫性を向上させるテキストからのモーション生成フレームワーク。
flow-matchingmotion-generationtext-to-motion -
MultiAct AIが発見
2026
複数の同時アクションを記述する複合プロンプトを処理するために、調整されたアテンションガイダンスを使用する、ペアデータ不要の推論時テキストモーション生成フレームワーク。
attention-guidancemotion-generationtext-to-motion -
2025
テキストプロンプトから任意の3Dメッシュをアニメーション化し、時間方向の頂点変形(4Dメッシュモーション)を生成して、動的アセットを素早く作成する。
4dmesh-animationtext-driven -
HY-Motion 1.0 AIが発見
2025
Diffusion Transformer (DiT) とフローマッチングに基づく10億パラメータ規模のテキスト3Dモーション生成モデルであり、指示追従性に優れた高品質なキャラクターアニメーションを生成します。
ditflow-matchingmotion-generationtext-to-motion -
InterAct AIが発見
2025
大規模な3D人間と物体の相互作用(HOI)生成フレームワークおよびベンチマーク。テキスト記述から動的で物理的に妥当な3Dの人間と物体の相互作用を生成する課題に対処し、接触のめり込みや浮遊アーティファクトを最小限に抑えます。
human-object-interactionmotion-generationtext-to-motion -
MoLingo AIが発見
2025
連続的かつ意味的に整列された潜在空間内で拡散(ディフュージョン)を行うことにより、リアルで生命力のある人間の動作を生成するテキストtoモーションモデル。
latent-diffusionmotion-generationtext-to-motion -
MoSa: Motion Generation with Scalable Autoregressive Modeling AIが発見
2025
粗い表現から細かい表現へのスケーラブルな生成プロセスを通じて、ベクトル量子化ガイド付き生成トランスフォーマーのパラダイムを強化する階層的モーション生成フレームワーク。
autoregressivetext-to-motionvq-vae -
Motion Anything: Any to Motion Generation AIが発見
2025
アテンションベースのマスクモデリング戦略を導入することで、動的なフレームや身体部位を優先し、生成されるモーションのきめ細かな空間的・時間的制御を可能にするモーション生成フレームワーク。
mask-modelingmotion-generationtext-to-motion -
MotionGPT3 AIが発見
2025
動作または言語の任意の入力シーケンスを処理し、どちらのモダリティでも出力を生成するバイモーダルな動作・言語モデル。変分オートエンコーダ(VAE)を用いて生の動作を連続的な潜在空間にエンコードすることで量子化によるアーティファクトを回避し、事前学習済み言語モデルのセマンティックプライアを活用します。
llmmotion-generationmultimodaltext-to-motion -
MotionLab AIが発見
2025
Motion-Condition-Motion (MCM) パラダイムに基づく、統合された人間の動作生成および編集フレームワーク。単一のモデル内で、テキストからの動作生成、動作のインビトウィーニング(中割り)、および細粒度の動作編集を含む多様なタスクをサポートします。
motion-editingmotion-generationtext-to-motion -
PersonaBooth AIが発見
2025
少数の参照モーションからマルチモーダルな微調整アプローチを用いて、モーションスタイルやアクターのペルソナをカスタマイズする、パーソナライズされたテキストtoモーション生成フレームワーク。
motion-generationpersonalizationtext-to-motion -
ReAlign: Text-to-Motion Generation via Step-Aware Reward-Guided Alignment AIが発見
2025
ReAlignは、ステップ認識型の報酬勾配を用いて拡散モデルの逆サンプリング軌道をガイドし、テキストからモーションへの生成におけるアライメントを向上させる、プラグアンドプレイの報酬誘導型サンプリングアライメントフレームワークです。
diffusion-modelmotion-generationtext-to-motion -
ReMoMask: Retrieval-Augmented Masked Motion Generation AIが発見
2025
検索拡張生成(RAG)とマスク型拡散モデルを統合することで、時間的一貫性と意味的整合性を備えた人間の動作を合成する、検索拡張マスク型テキスト・トゥ・モーション生成フレームワーク。
masked-diffusionragtext-to-motion -
SnapMoGen AIが発見
2025
細粒度な制御のために、表現力豊かで詳細なテキストアノテーションを備えた高品質データセットで訓練されたテキスト駆動型動作生成フレームワーク。
datasetmotion-generationtext-to-motion -
TSTMotion: Training-free Scene-aware Text-to-motion Generation AIが発見
2025
TSTMotionは、追加の学習を必要としない、3Dシーンを考慮したテキストからのモーション生成フレームワークです。高コストな実測のシーン・モーション学習データを必要とせず、多様な3D屋内環境と相互作用するリアルな人間モーションシーケンスの合成を可能にします。
3d-scenescene-awaretext-to-motiontraining-free -
AnimationGPT AIが発見
2024
テキストプロンプトからゲームの戦闘モーションアセットを生成するために特別に設計されたオープンソースの生成AIツール。MotionGPTでトレーニングされており、ゲームスタイルの戦闘アニメーションに特化したCombatMotionデータセットを導入しています。
combatmotiongame-combatmotion-generationtext-to-motion -
AToM: Aligning Text-to-Motion Model at Event-Level with GPT-4Vision Reward AIが発見
2024
GPT-4Visionからのフィードバックと報酬を活用することで、生成された3D人間の動作とイベントレベルのテキストプロンプトとのアライメントを強化するフレームワーク。
alignmentmotion-generationtext-to-motion -
Large Motion Model (LMM) AIが発見
2024
テキストからのモーション生成や音楽からのダンス生成など、多様なモーション生成タスクを単一の汎用モデルに統合した、モーション中心のマルチモーダルフレームワーク。
foundation-modelmotion-generationmulti-modal -
Light-T2M AIが発見
2024
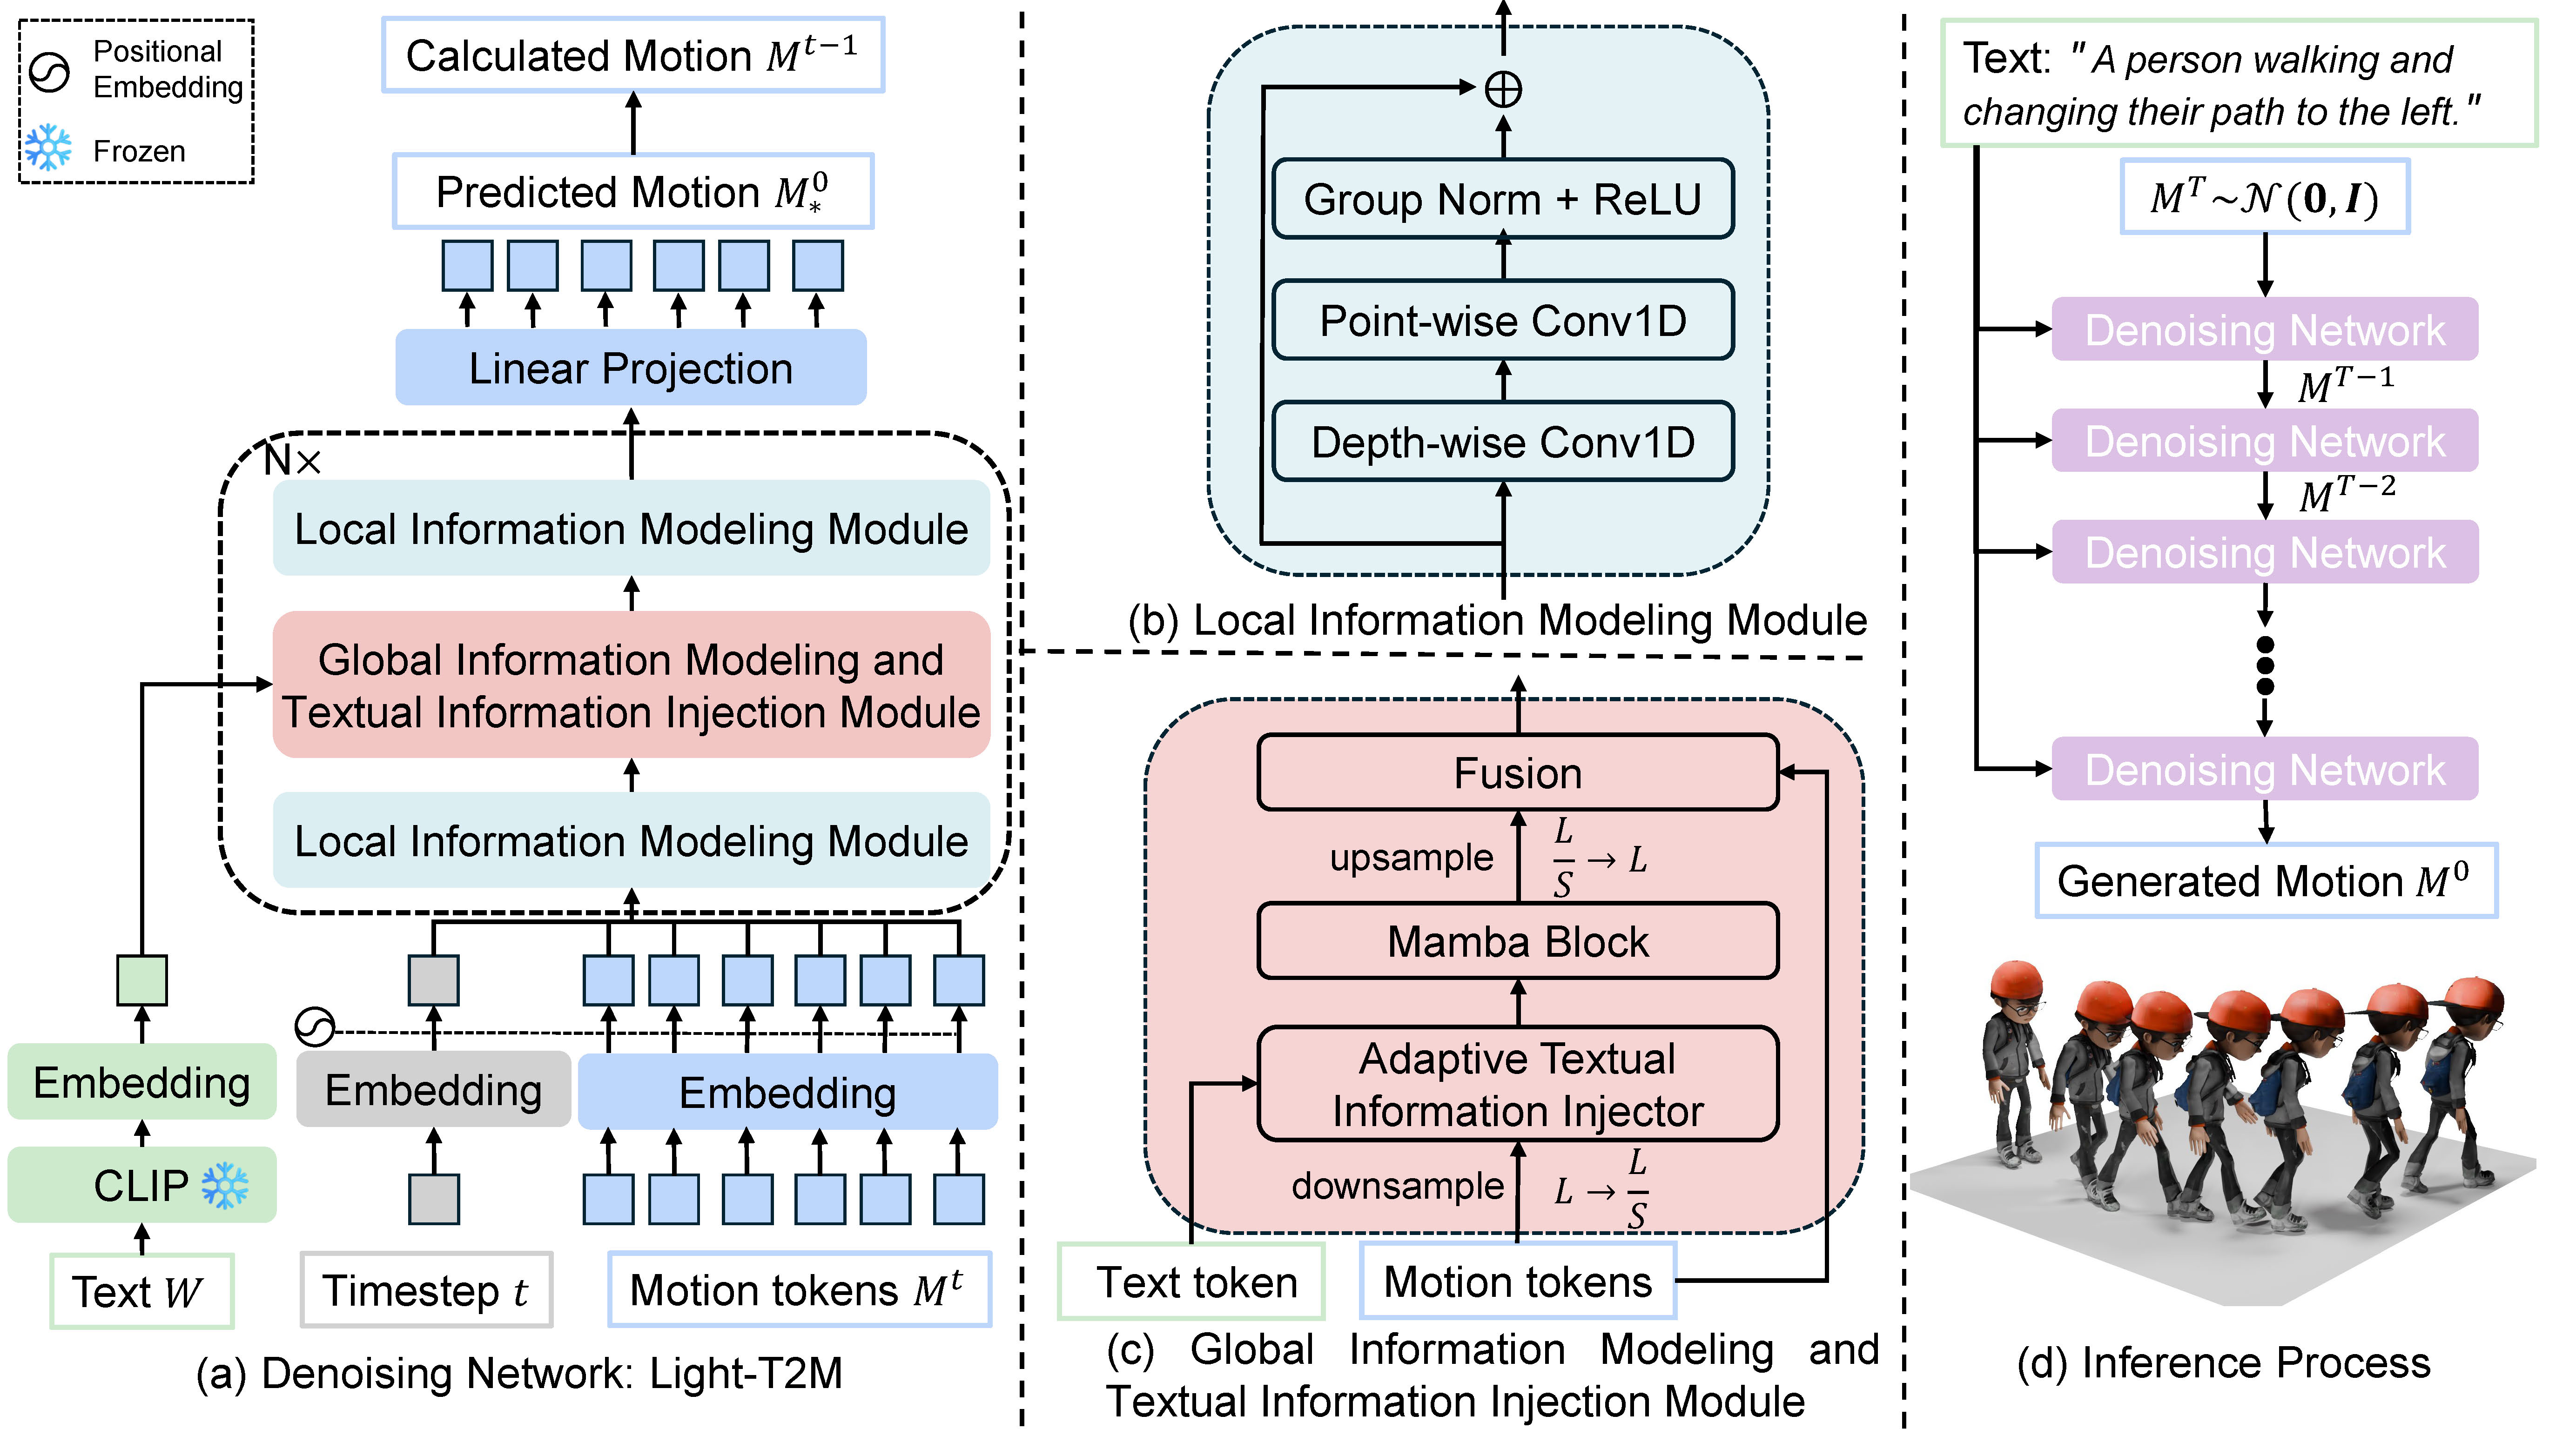
Light-T2MはAAAI 2025に採択された軽量かつ高速なテキスト2モーション生成モデルであり、局所モーションモデリングと適応型テキスト注入によりパラメータ数と推論遅延を大幅に削減します。
3d-animationlightweightreal-timetext-to-motion -
MARDM AIが発見
2024
離散的なベクトル量子化(VQ)手法の限界に対処するため、連続的な動作表現に対するマスク付き自己回帰モデルを採用し、動作の多様性と品質を維持するテキストからのモーション生成フレームワーク。
diffusionmotion-generationtext-to-motion -
Motion-Agent: A Conversational Framework for Human Motion Generation with LLMs AIが発見
2024
事前学習済みの言語モデルを利用して動作とテキストのギャップを埋める、人間の動作生成、編集、および理解のための効率的な対話型フレームワーク。
conversational-agentllmtext-to-motion -
MotionGPT3: Human Motion as a Second Modality AIが発見
2024
MotionGPT3は、人間の動作を第二のモダリティとしてモデル化する統一されたモーション言語フレームワークであり、Mixture-of-Tokens(MoT)アーキテクチャを利用して高精度な動作理解と生成を実現します。自然言語と3Dの人間の動作との間のシームレスな双方向翻訳を可能にします。
llmmotion-generationtext-to-motion -
MotionLCM: Real-time Controllable Motion Generation via Latent Consistency Model AIが発見
2024
潜在整合モデル(Latent Consistency Model)に基づくリアルタイムで制御可能なテキストからのモーション生成フレームワークを提案し、わずか数ステップのデノイジングで高品質な3D人間の動作合成を可能にします。
consistency-modelmotion-generationreal-timetext-to-motion -
Multi-Track Timeline Control (STMC) AIが発見
2024
NVIDIAとMPIによって開発された本フレームワークは、マルチトラックタイムラインによるテキスト2モーション制御を実現し、複数のテキスト指示モーションの重ね合わせやタイミング編集を可能にします。
3d-animationnvidiatext-to-motiontimeline-control -
ParCo: Part-Coordinating Text-to-Motion Synthesis AIが発見
2024
細粒度でリアルな動作生成を実現するために、部位の分割と協調メカニズムを導入した、部位協調型のテキストからのモーション合成手法。
motion-generationpart-coordinationtext-to-motion -
ScaMo AIが発見
2024
テキストから動作を生成するタスクにおけるスケーリング則を探求するために設計された、スケーラブルな自己回帰型動作生成フレームワークです。安定した高精度な動作量子化を実現するMotion FSQ-VAEトークナイザーと、テキストプレフィックス自己回帰トランスフォーマーを採用し、最大30億パラメータまで拡張可能です。
motion-generationscaling-lawtext-to-motion -
SoPo: Text-to-Motion Generation Using Semi-Online Preference Optimization AIが発見
2024
SoPo(Semi-Online Preference Optimization)は、テキストからモーションを生成するモデル向けの強化学習ベースの微調整フレームワークです。オンラインとオフラインの直接嗜好最適化(DPO)の利点を組み合わせることで、過学習やサンプリングの偏りを防ぎつつ、高品質で人間の好みに合致した3Dモーションを一貫して生成します。
diffusion-modelfine-tuningpreference-optimizationtext-to-motion -
TeSMo: Generating Human Interaction Motions in Scenes with Text Control AIが発見
2024
デノイジング拡散モデルに基づき、目標到達の制約とシーンの相互作用を組み込んだ、シーンを考慮したテキストからのモーション生成フレームワーク。
diffusionmotion-generationtext-to-motion -
Text-To-VRMA AIが発見
2024
テキスト記述からVRMアニメーション(.vrma)ファイルを生成するために設計されたオープンソースのWebアプリケーションです。日本語と英語のプロンプトに対応し、LLMキーフレーム生成やNVIDIA ARDYエンジンを利用して、ブラウザ上でVRMキャラクターのモーションをプレビュー・エクスポートできます。
text-to-motionvrmvrmavtuber -
VersatileMotion: A Unified Framework for Motion Synthesis and Comprehension AIが発見
2024
モーショントークナイザーと自己回帰トランスフォーマーを介して大規模言語モデル(LLM)を適応させ、動作生成と動作理解の両方のタスクを実行する統一フレームワーク。
llmmotion-understandingtext-to-motion -
MoMask AIが発見
2023
テキスト駆動の3D人間動作生成のための生成型マスクモデリングフレームワーク。階層的量子化スキームを用いて動作を多層の離散モーショントークンとして表現し、双方向Transformerを用いて生成します。
masked-modelingmotion-generationtext-to-motion -
MotionGPT AIが発見
2023
人間の動作を「外国語」として扱う、統一された動作と言語の生成モデル。3D動作を離散コードにトークン化し、テキストと動作トークンの両方で大規模言語モデル(LLM)を訓練することで、テキストからの動作生成、動作からのテキスト生成、動作予測などを可能にします。
llmmotion-generationtext-to-motion -
MotionGPT: Finetuned LLMs are General-Purpose Motion Generators AIが発見
2023
MotionGPTは、テキストやシングルフレームのポーズなどのマルチモーダルな制御信号を大規模言語モデル(LLM)の特殊な入力トークンとして扱い、連続する人間の動作を生成する統一されたモーション言語フレームワークです。事前学習済みLLMの強力な言語生成能力とゼロショット転移能力を活用し、多様な動作関連タスクに対応します。
llmmotion-generationtext-to-motion -
T2M-GPT AIが発見
2023
ベクトル量子化変分オートエンコーダー(VQ-VAE)とGenerative Pre-trained Transformer(GPT)に基づく、テキスト記述から人間の動作を生成するためのシンプルかつ効果的な条件付き生成フレームワーク。
gptmotion-generationtext-to-motionvq-vae -
Human Motion Diffusion Model (MDM)
2022
テキストや動作から人体モーションを生成する軽量な拡散モデル。アニメーション研究におけるテキスト→モーションの定番ベースライン。
diffusionmotion-generation -
Motion Latent Diffusion (MLD) AIが発見
2022
低次元の潜在空間で動作する、高速かつ高品質な動作拡散モデル。動作とテキストのモダリティ間に共同潜在空間を構築し、効率的で多様なテキストからの動作生成を可能にします。
diffusion-modelmotion-generationtext-to-motion -
MotionDiffuse AIが発見
2022
多様で細粒度な3D人間の動作合成を可能にする、最初期の拡散モデルベースのテキスト駆動型動作生成フレームワーク。
diffusionmotion-generationtext-to-motion

商用・業界ツール
-
Cartwheel AIが発見
2024
テキストプロンプトや参照ビデオから、プロダクション品質の3Dキャラクターアニメーションを作成するために設計されたジェネレーティブAIアニメーションプラットフォーム。
commercialmotion-generationtext-to-motion -
SayMotion AIが発見
2024
テキストプロンプトを高品質な3Dキャラクターアニメーションに変換する、DeepMotionによるWebベースの生成AIプラットフォーム。FBX、GLB、BVH形式でのエクスポートに対応しています。
motion-generationonline-toolproprietarytext-to-motion -
SayMotion by DeepMotion AIが発見
2024
自然言語のテキストプロンプトを高品質な3Dキャラクターアニメーションに変換する、ブラウザベースの商用ジェネレーティブAIサービス。
commercialmotion-generationtext-to-motion -
Unity Muse Animate AIが発見
2024
テキストプロンプトと機械学習支援ポージングを使用して、Unityエディタ内で直接、自然なキャラクターアニメーションを生成および編集できる、Unity公式のAI搭載アニメーションツール。
commercialmotion-generationtext-to-motionunity